


Proxy-Server-Verfügbarkeit sichern: Ein praktischer Leitfaden für einen zuverlässigen Betrieb

David
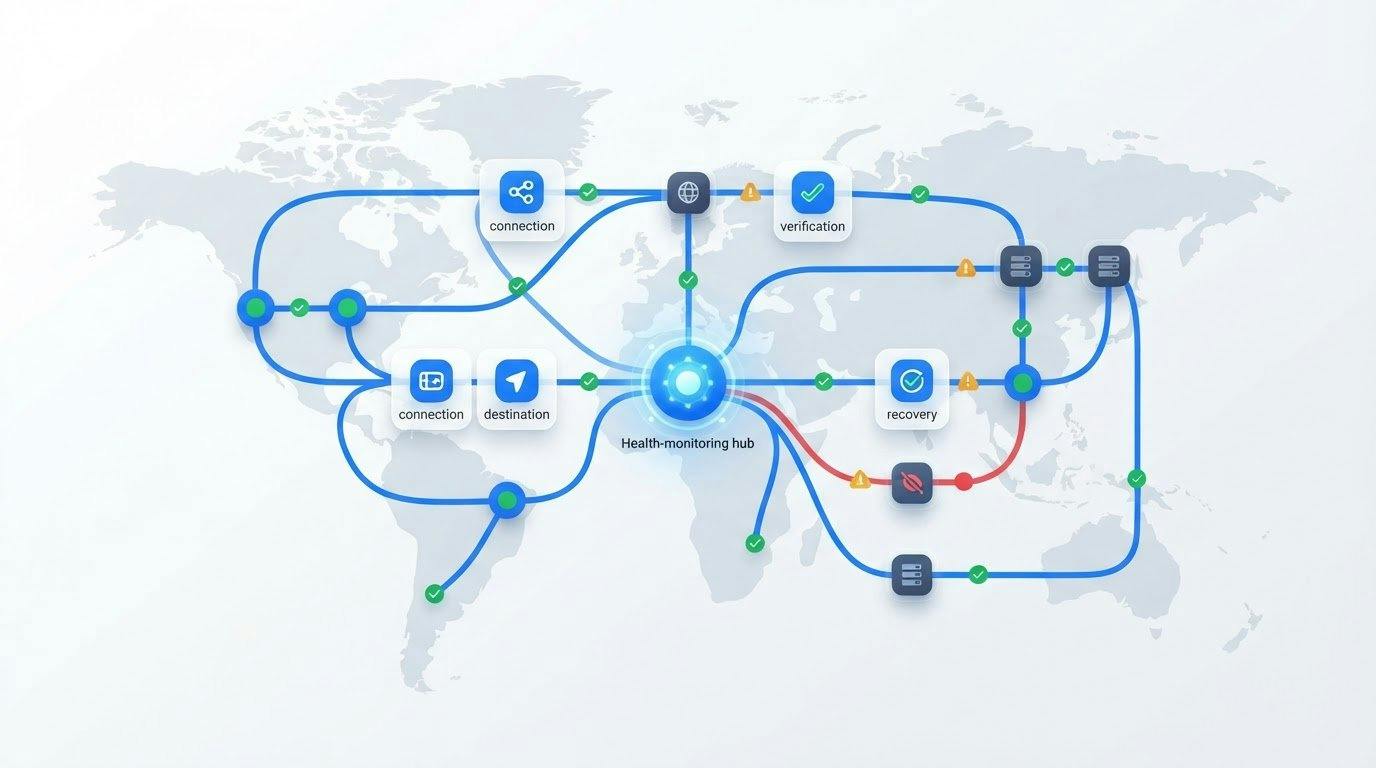
Was, wenn Ihr Proxy auf einen Health Check antwortet, die Aufgabe aber trotzdem nicht erledigen kann? Ein erreichbarer Endpunkt garantiert nicht, dass Scraping, Automatisierung oder Datenerfassung zuverlässig laufen. Die Verfügbarkeit eines Proxy-Servers zu sichern bedeutet, zu messen, ob der gesamte Workflow erfolgreich ist, nicht nur, ob sich eine Verbindung herstellen lässt.
Eine langsame Antwort, ein blockiertes Ziel, ein Anwendungsfehler oder ein Proxy-Ausfall können alle wie derselbe Ausfall aussehen. Um die Ursache zu finden und Störungen zu begrenzen, nutzen Sie Prüfungen, die reale Aufgaben abbilden, und eine einheitliche Methode, um festzustellen, wo ein Fehler beginnt.
Dieser Leitfaden erklärt, wie Sie die Proxy-Verfügbarkeit an den Anforderungen der Arbeitslast messen, Probleme erkennen und diagnostizieren und Wiederherstellungsmaßnahmen planen. Außerdem zeigt er, wie Sie die Infrastruktur auf die Aufgabe abstimmen, von Residential- und Rechenzentrum-Proxys bis zu dedizierten mobilen Optionen und gehosteter Infrastruktur.
Das Wichtigste in Kürze
- Messen Sie die Verfügbarkeit daran, ob proxyabhängige Aufgaben innerhalb akzeptabler Leistungsgrenzen abgeschlossen werden, nicht nur daran, ob ein Endpunkt antwortet.
- Erfassen Sie Latenz, Anfragefehler und abgeschlossene Aufgaben, um Anwendungs-, Netzwerk-, Proxy- und Zielfehler besser zu unterscheiden.
- Vergleichen Sie Redundanz, Rotation und Failover sorgfältig. Rotierende IPs allein verhindern nicht jede Unterbrechung.
- Nutzen Sie ein Wiederherstellungs-Runbook mit begrenzten Wiederholungen und Backoff, um Ausfälle einzudämmen und den Dienst methodisch wiederherzustellen.
- Um die Verfügbarkeit eines Proxy-Servers zu sichern, stimmen Sie die Infrastruktur auf Sitzungs-, Standort-, Volumen- und Wiederherstellungsanforderungen ab und bewerten Sie sie anhand realer Workflow-Ergebnisse.
Proxy-Server-Verfügbarkeit beginnt mit der Messung des gesamten Workflows
Ein Proxy kann eine Verbindung annehmen und trotzdem keinen nützlichen Dienst liefern. Eine Anfrage kann in ein Timeout laufen, zu lange dauern oder ein Ziel erreichen, ohne das Ergebnis zu liefern, das eine Anwendung benötigt. Die Verfügbarkeit eines Proxy-Servers zu sichern beginnt damit, Erfolg aus Sicht der Arbeitslast zu definieren, statt sich auf eine einfache Prüfung „Server antwortet“ zu verlassen.
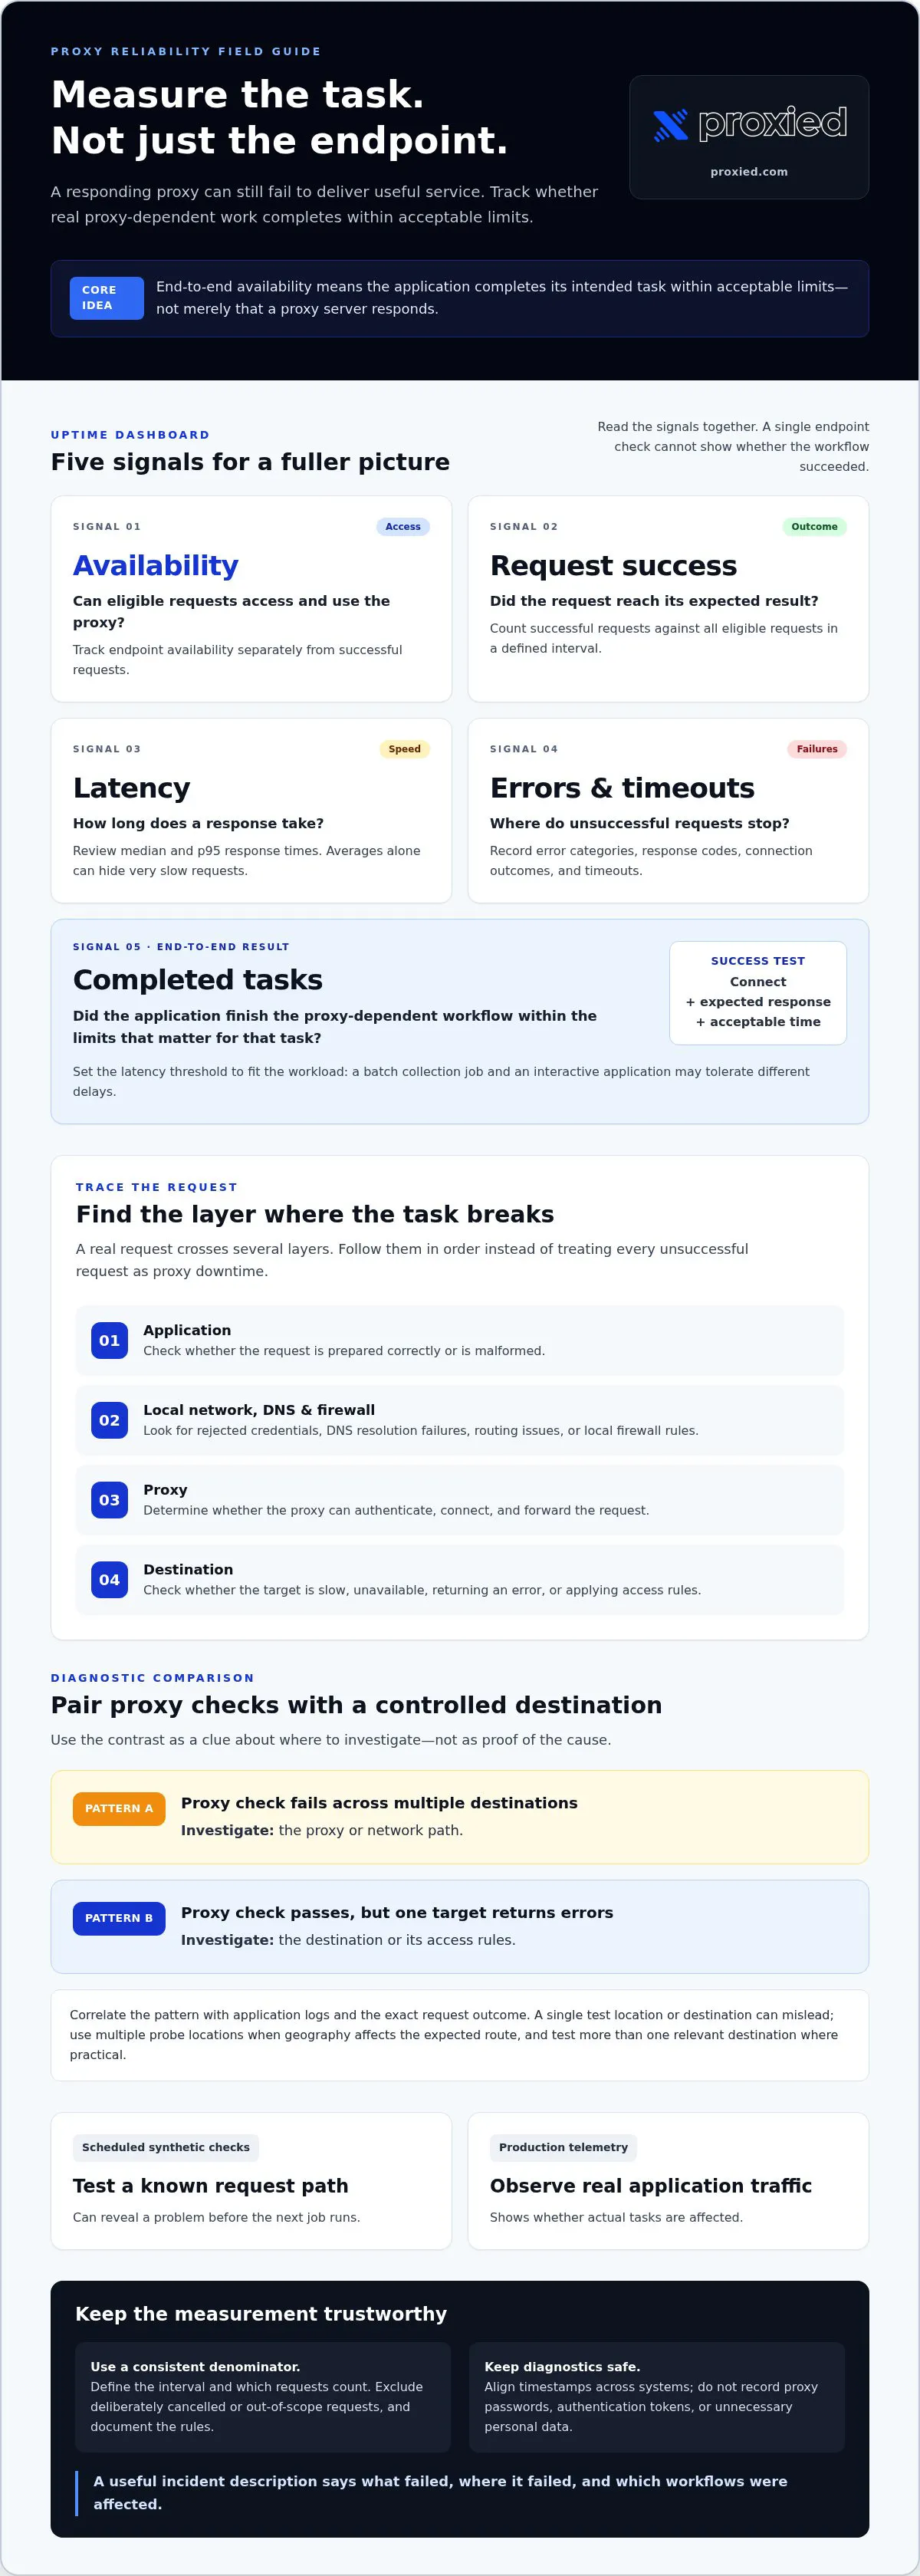
Die Proxy-Verfügbarkeit misst, ob der Proxy berechtigte Anfragen annehmen und verarbeiten kann; die End-to-End-Verfügbarkeit des Dienstes misst, ob die Anwendung ihre vorgesehene Aufgabe innerhalb akzeptabler Grenzen abschließt. Erfassen Sie diese Werte getrennt. Die Verfügbarkeit zeigt, ob der Zugang funktioniert, die Latenz, wie lange eine Antwort dauert, und die Fehlerrate erfasst erfolglose Anfragen. Zielzugriff und abgeschlossene Workflows liefern weiteren Kontext.
Was misst die Verfügbarkeit eines Proxy-Servers?
Wählen Sie einen Messzeitraum, der zu Ihrem Reporting passt, und legen Sie dann fest, welche proxyabhängigen Anfragen zählen. Eine Prüfung kann eine Anfrage zum Beispiel nur dann als erfolgreich werten, wenn sie über den Proxy verbunden wird, eine erwartete Antwort vom Ziel erhält und innerhalb des Latenzschwellenwerts der Arbeitslast abgeschlossen wird. Der richtige Schwellenwert hängt von der Aufgabe ab: Ein Batch-Erfassungsjob und eine interaktive Anwendung können unterschiedliche Verzögerungen tolerieren.
Erfassen Sie die Erreichbarkeit des Endpunkts getrennt von Anfrageerfolg, Latenz und Zielantwort. So wird verhindert, dass eine schnelle, aber unbrauchbare Verbindung als gesund erscheint oder eine langsame Verbindung als voll verfügbar gilt, nur weil sie irgendwann geantwortet hat. Grundlegende Informationen dazu, wie ein Proxy-Server Anfragen zwischen Clients und anderen Servern verarbeitet, finden Sie in der Übersicht auf Wikipedia.
Warum die Proxy-Verfügbarkeit die Anwendung einschließen muss
Eine reale Anfrage durchläuft mehrere Ebenen. Die Anwendung bereitet sie vor, das lokale Netzwerk und DNS lösen die Route auf, der Proxy authentifiziert und leitet sie weiter, und das Ziel verarbeitet sie. Ein Fehler in jedem dieser Schritte kann die Aufgabe unterbrechen. Falsche Zugangsdaten, DNS-Auflösungsfehler, lokale Firewall-Regeln, Zielfehler und Probleme mit der Proxy-Konnektivität können für Anwendungsnutzer ähnlich aussehen.
Einfache Konnektivitätstests sind nützlich, beweisen aber nicht, dass ein realer Job abgeschlossen werden kann. Erfassen Sie auch Ergebnisse aus repräsentativen Anwendungspfaden: ob die Anfrage abgeschlossen wurde, wie lange jeder Schritt gedauert hat und welcher Fehler aufgetreten ist. Vergleichen Sie diese Ergebnisse mit direkten Endpunktprüfungen. Antwortet der Endpunkt, aber die Anwendungsaufgabe schlägt fehl, haben Sie einen engeren Untersuchungsbereich, als ihn eine einfache Verfügbarkeitszahl liefert.
Wie Proxy-Ausfälle entstehen und welche Signale sie erkennbar machen
Sobald Sie eine erfolgreiche Aufgabe definiert haben, überwachen Sie die Stellen, an denen sie scheitern kann. Eine nützliche Diagnose trennt Anwendungsfehler von Proxy-Problemen, statt jede erfolglose Anfrage als Ausfall zu behandeln. Prüfen Sie die Ebenen der Reihe nach: Die Anwendung kann eine fehlerhafte Anfrage senden; Zugangsdaten können abgelehnt werden; DNS, Routing oder eine Firewall können den Netzwerkpfad stören; der Proxy kann keine Verbindung herstellen; oder das Ziel kann langsam, nicht verfügbar sein oder einen Fehler zurückgeben.
Welche Kennzahlen zur Proxy-Verfügbarkeit sollten Teams erfassen?
Messen Sie erfolgreiche Anfragen im Verhältnis zu allen berechtigten Anfragen in einem festgelegten Intervall und halten Sie den Nenner konstant. Schließen Sie bewusst abgebrochene Anfragen oder solche außerhalb des überwachten Workflows aus, dokumentieren Sie diese Regeln aber. Erfassen Sie die Verfügbarkeit zusammen mit Latenzverteilungen wie Median- und p95-Antwortzeiten, Timeouts, Anfragefehlern und abgeschlossenen Aufgaben. Durchschnittswerte allein können eine kleinere Gruppe sehr langsamer Anfragen verbergen, die eine Arbeitslast stören.
Nutzen Sie synthetische Prüfungen, um einen bekannten Anfragepfad regelmäßig zu testen, und vergleichen Sie sie mit Produktions-Telemetrie aus echtem Anwendungs-Traffic. Synthetische Prüfungen können ein Problem aufdecken, bevor der nächste Job läuft; Produktionsdaten zeigen, ob tatsächliche Aufgaben betroffen sind. Protokollieren Sie nützliche Diagnosedaten wie Zeitstempel, Fehlerkategorien, Antwortcodes und Verbindungsergebnisse. Speichern Sie keine Proxy-Passwörter, Authentifizierungstoken oder unnötige personenbezogene Daten.
Wie kann Monitoring Proxy-Fehler von Zielfehlern unterscheiden?
Kombinieren Sie Proxy-Health-Checks mit Anfragen an ein kontrolliertes, stabiles Ziel. Schlägt die Proxy-Prüfung bei mehreren Zielen fehl, untersuchen Sie den Proxy oder den Netzwerkpfad. Ist sie erfolgreich, aber ein Ziel liefert Fehler, können das Ziel oder seine Zugriffsregeln die Ursache sein. Behandeln Sie diesen Vergleich als Hinweis, nicht als Beweis, und gleichen Sie ihn mit den Anwendungsprotokollen und dem genauen Anfrageergebnis ab.
Halten Sie die Zeitstempel in Monitoring- und Anwendungssystemen synchron. Vergleichen Sie Antwortcodes, DNS-Ergebnisse, Verbindungsfehler und Timeouts, um zu sehen, wo die Anfrage stehen geblieben ist. Ein einzelner Teststandort oder ein einzelnes Ziel kann in die Irre führen: Das lokale Routing kann beeinträchtigt sein, oder ein Ziel hat ein isoliertes Problem. Nutzen Sie mehrere Prüfstandorte, wenn die Geografie die erwartete Route beeinflusst, und testen Sie nach Möglichkeit mehr als ein relevantes Ziel.
Diese Signale machen aus „der Proxy ist ausgefallen“ eine nützlichere Störungsbeschreibung: was fehlgeschlagen ist, wo es fehlgeschlagen ist und welche Workflows betroffen waren. Gleichen Sie diese Muster im Rahmen der Verfügbarkeitssicherung mit den Konnektivitätsanforderungen jeder Aufgabe ab. Entdecken Sie Infrastrukturoptionen für Proxys für Arbeitslasten mit mobilen, Residential- oder Rechenzentrum-Verbindungen.
Strategien für Proxy-Verfügbarkeit im Vergleich: Redundanz, Rotation und Failover
Resilienz entsteht, wenn das Wiederherstellungsdesign zur Aufgabe passt. Ein Workflow, der pausieren und erneut versuchen kann, braucht möglicherweise ein einfacheres Setup als einer, der von einer konsistenten Sitzung abhängt oder in einem engen Zeitfenster abgeschlossen werden muss. Kein Proxy-Typ und keine Routing-Strategie garantiert, dass jede Anfrage erfolgreich ist; testen Sie daher den gesamten Workflow und legen Sie fest, wie viel Störung er verkraften kann.
- Einzelner Endpunkt: Einfach zu konfigurieren, doch ein Ausfall kann Anfragen stoppen, bis sich der Endpunkt erholt.
- Mehrere Endpunkte: Gibt der Anwendung Alternativen, sofern sie einen fehlerhaften Endpunkt erkennen und einen anderen wählen kann.
- Rotation: Verteilt Anfragen auf mehrere IPs, doch die Wahl einer neuen IP stellt eine fehlgeschlagene Verbindung oder Aufgabe nicht von selbst wieder her.
- Kontrolliertes Failover: Wechselt nach einem definierten Fehlersignal zu einer konfigurierten Alternative. Es kann Störungen verkürzen, erfordert aber klare Prüfungen und Wiederherstellungsregeln.
Planen Sie anhand der Sitzungsanforderungen, der Toleranz der Arbeitslast und der Wiederherstellungsziele. Ein Batch-Job, der fortgesetzt werden kann, nutzt zum Beispiel Wiederholungen und einen anderen Endpunkt, während ein Workflow mit Login-Sitzung seine Verbindungsidentität während der Wiederherstellung möglicherweise beibehalten muss. Zusätzliche Endpunkte bedeuten auch mehr Konfigurations- und Monitoring-Aufwand. Mehr Optionen helfen nur, wenn die Anwendung sie sicher nutzen kann.
Wann beeinflussen Rotation und Sticky Sessions die Zuverlässigkeit?
Rotation ändert, welche IP eine Anfrage verarbeitet. Das kann den Traffic verteilen, doch eine wechselnde Identität kann Workflows stören, die auf eine konsistente Sitzung angewiesen sind. Sticky Sessions halten Anfragen für einen Zeitraum oder eine Sitzung an derselben Proxy-Identität, was zu Login-basierten Aufgaben passen kann. Der Nachteil: Eine Sticky-Route kann an einen problematischen Endpunkt gebunden bleiben; legen Sie daher fest, wie die Anwendung Ausfälle erkennt und sich davon erholt.
Wie sollten Teams Proxy-Typen hinsichtlich Resilienz vergleichen?
Beginnen Sie mit den Konnektivitätsanforderungen der Aufgabe, nicht mit einer allgemeinen Rangliste. Rechenzentrum-Proxys können zu Arbeitslasten passen, bei denen Geschwindigkeit und Skalierung zählen; Residential Proxys eignen sich für standortabhängige Aufgaben; mobile Proxys sind relevant, wenn ein Workflow Mobilfunkkonnektivität benötigt. Dedizierte 4G- und 5G-Mobile-Optionen, Residential Proxys und Rechenzentrum-Proxys decken unterschiedliche Anforderungen ab, doch keine Option ersetzt Endpunkt-Monitoring und Wiederherstellungsplanung.
Redundanz kann sich über mehrere Endpunkte oder, sofern das Setup es unterstützt, über unterschiedliche Proxy-Infrastruktur erstrecken. Testen Sie das Failover mit echten Anwendungsanfragen einschließlich der Sitzungshandhabung, statt anzunehmen, dass sich eine Ausweichroute identisch verhält. Einen genaueren Blick auf die Wahl zwischen zwei gängigen Optionen bietet der Leitfaden zur Auswahl zwischen mobilen und Residential Proxys. Die richtige Wahl unterstützt die Arbeitslast; sie garantiert keinen unterbrechungsfreien Dienst.
Ein praktisches Runbook für Erkennung und Wiederherstellung
Ein Runbook macht aus einem Alarm eine kontrollierte Reaktion. Legen Sie vor einem Vorfall fest, wer handelt, welche Belege geprüft werden und wie die Anwendung in den Betrieb zurückkehrt. So wird die Sicherung der Proxy-Server-Verfügbarkeit zu einem wiederholbaren Betriebsprozess statt zu einem hektischen Raten, welche Ebene ausgefallen ist.
Was sollte passieren, wenn Proxy-Anfragen fehlschlagen?
Lösen Sie Alarme bei anhaltenden Veränderungen von Fehlern oder Timeouts oder bei einem Rückgang abgeschlossener Workflows aus. Vermeiden Sie Alarme bei einer einzelnen fehlgeschlagenen Anfrage, wenn sie vorübergehend sein könnte. Folgen Sie dann einer einheitlichen Reihenfolge:
- Erkennen: Bestätigen Sie den Alarm anhand der Monitoring-Daten und ermitteln Sie die betroffenen Workflows.
- Einordnen: Prüfen Sie Anwendungsprotokolle, Zugangsdaten, Netzwerkerreichbarkeit, Proxy-Antworten und Zielverhalten, um die fehlerhafte Ebene einzugrenzen.
- Eindämmen: Pausieren oder begrenzen Sie betroffene Arbeit, wenn weitere Anfragen doppelte Aktionen auslösen, Zustände beschädigen oder einen überlasteten Dienst zusätzlich belasten könnten.
- Wiederherstellen: Wenden Sie dokumentierte Ausweichregeln an, etwa den Wechsel zu einem freigegebenen Endpunkt, und wahren Sie dabei Sitzungs- und Datenintegrität.
- Überprüfen: Bestätigen Sie die Wiederherstellung durch erfolgreiche Anwendungsanfragen, nicht nur durch einen antwortenden Proxy-Endpunkt.
- Auswerten: Dokumentieren Sie Zeitablauf, Auswirkungen, Ursache und Folgemaßnahmen, damit derselbe Ausfall leichter erkannt und behoben werden kann.
Wiederholungen sollten begrenzt sein und Backoff nutzen, das Versuche zeitlich verteilt, statt sie ununterbrochen zu senden. Legen Sie eine maximale Anzahl von Versuchen fest und stoppen Sie, wenn das Limit erreicht ist. So wird verhindert, dass ein ausgefallener Proxy oder ein Ziel mit einer Welle wiederholter Anfragen überflutet wird. Ein Circuit Breaker kann den Traffic zu einer Route nach wiederholten Fehlern vorübergehend stoppen und dann einen begrenzten Test zulassen, sobald eine Wiederherstellung möglich ist. Testen Sie Health Checks anhand aussagekräftiger Anfragepfade und Failover-Regeln.
Wie können Teams wiederholte Proxy-Ausfälle verhindern?
Legen Sie die Verantwortung für Vorfälle im Voraus fest. Dokumentieren Sie Eskalationsschritte, Bedingungen für Ausweichlösungen und wer Jobs pausieren oder fortsetzen darf. Vergleichen Sie nach einem Vorfall die Alarme mit den Produktionsprotokollen, ermitteln Sie blinde Flecken und testen Sie das Wiederherstellungsverfahren in einer kontrollierten Umgebung. Aktualisieren Sie das Runbook, wenn ein Test unklare Schritte oder unsichere Wiederholungen aufdeckt.
Für Teams, die ihre eigene Proxy-Infrastruktur verwalten, kann eine Proxy-Hosting-Plattform helfen, diese Umgebung zu organisieren und zu betreiben. Prüfen Sie, wie die Plattform zu Ihren Verwaltungsanforderungen passt, einschließlich der Frage, wie Sie die Infrastruktur überwachen und auf Probleme reagieren. Ein praktischer Verfügbarkeitsplan hängt außerdem von einer Infrastruktur ab, die zur Arbeitslast passt, ob mit mobilem, Residential- oder Rechenzentrum-Proxy-Zugang. Entdecken Sie Optionen für Proxy-Zugang und Hosting als Teil Ihrer Resilienzplanung.
Proxy-Infrastruktur passend zu Ihren Verfügbarkeitsanforderungen wählen
Die richtige Infrastruktur hängt davon ab, was Ihre Anwendung erledigen muss und wie schnell sie sich nach einem Verbindungsausfall erholen muss. Dokumentieren Sie die Workflow-Anforderungen, bevor Sie Proxy-Optionen vergleichen. So haben Sie eine praktische Grundlage, um Optionen anhand Ihrer eigenen Ergebnisse zu bewerten, statt eine allgemeine Leistungsaussage als Eignungsnachweis zu behandeln. Kein Proxy-Typ allein garantiert Verfügbarkeit oder erfolgreiche Anfragen.
Was sollte eine verfügbarkeitsorientierte Proxy-Bewertung umfassen?
Machen Sie aus Ihren Anforderungen eine kurze Bewertungscheckliste:
- Sitzungen: Benötigt die Aufgabe eine konsistente Identität über zusammenhängende Anfragen hinweg, oder kann sie unterschiedliche Verbindungen nutzen?
- Geografie: Welche Standorte muss der Workflow erreichen, und müssen die Ergebnisse eine bestimmte Region widerspiegeln?
- Volumen: Welche Anfragemuster und Lastniveaus sollte das Setup bewältigen?
- Wiederherstellung: Wie viel Unterbrechung verträgt die Aufgabe, und wie schnell sollte sie wieder anlaufen?
- Messung: Was gilt für diese Anwendung als Erfolg, einschließlich akzeptabler Antwortzeit und abgeschlossener Arbeit?
Legen Sie Erwartungen an Verfügbarkeit und Wiederherstellung für den Workflow fest und testen Sie dann jede Option über denselben Anwendungspfad. Vergleichen Sie abgeschlossene Aufgaben, Fehler, Latenz und Wiederherstellungsverhalten unter repräsentativen Bedingungen. Prüfen Sie auch Monitoring- und Betriebsinformationen, etwa wie Sie den Zustand des Dienstes beobachten und wer für die Reaktion auf Probleme verantwortlich ist. Bewerten Sie gemessene Ergebnisse zusammen mit den Dienstinformationen, nicht allein anhand von Aussagen.
Wählen Sie die Infrastruktur nach Ihren Konnektivitätsanforderungen. Proxied bietet dedizierte 4G- und 5G-Mobile-Proxys sowie Residential- und Rechenzentrum-Proxy-Optionen. Diese dienen unterschiedlichen Einsatzzwecken; bewerten Sie daher jede Option anhand der Sitzungen, der Geografie und der Arbeitslast, die Ihre Anwendung erfordert. Betrachten Sie die Ergebnisse als Nachweis für Ihre eigenen Betriebsbedingungen, nicht als Versprechen identischer Leistung in jedem Szenario.
Wann kann Proxy-Hosting die Kontrolle über die Infrastruktur unterstützen?
Eine Proxy-Hosting-Plattform kann Teams unterstützen, die ihre eigene Proxy-Infrastruktur verwalten, indem sie einen Ort bietet, an dem sie gehostet und verwaltet wird. Das kann zu Teams passen, die mehr Kontrolle über ihr betriebliches Setup wünschen, macht die Verwaltung der Infrastruktur aber zu ihrer Verantwortung. Hosting-Kontrolle ist nicht dasselbe wie End-to-End-Verfügbarkeit der Anwendung: Anwendung, Netzwerkpfad, Zugangsdaten und Ziel können weiterhin beeinflussen, ob eine Aufgabe gelingt.
Wählen Sie im Rahmen der Verfügbarkeitssicherung den Ansatz, der sowohl zu den technischen Anforderungen als auch zur Betriebskapazität Ihres Teams passt. Prüfen Sie, wie Proxy-Hosting zu Ihren Prozessen für Infrastrukturverwaltung und Wiederherstellung passt. Überprüfen Sie das Setup erneut, wenn sich Workflows, Sitzungsanforderungen oder Wiederherstellungserwartungen ändern. Ziel ist nicht nur die Wahl einer Proxy-Kategorie, sondern eine messbare Passung zwischen der Infrastruktur und der Arbeit, die sie unterstützen muss.
Erstellen Sie einen Verfügbarkeitsplan, der zu Ihrem Workflow passt
Ein zuverlässiger Proxy-Betrieb beginnt mit einem klaren Erfolgsmaß: ob die Anwendung ihre Arbeit abschließt, nicht nur ob ein Proxy-Endpunkt antwortet. Erfassen Sie Anfrageergebnisse und Latenz, nutzen Sie Monitoring, um Fehler zu lokalisieren, und folgen Sie einem getesteten Wiederherstellungsplan mit begrenzten Wiederholungen und passenden Ausweichlösungen.
Zur Sicherung der Proxy-Server-Verfügbarkeit gehört auch, die Infrastruktur passend zu Sitzungsanforderungen, Geografie, Arbeitslast und Wiederherstellungserwartungen zu wählen. Proxied bietet dedizierte 4G- und 5G-Mobile-Proxys, Residential- und Rechenzentrum-Proxy-Optionen für unterschiedliche Konnektivitätsanforderungen sowie eine Plattform zur Verwaltung und Skalierung Ihrer eigenen Proxy-Infrastruktur. Diese Optionen gehören in einen umfassenderen Resilienzplan und ersetzen nicht die Messung von End-to-End-Ergebnissen.
Entdecken Sie Proxy- und Hosting-Lösungen von Proxied, um Infrastrukturoptionen für Ihren Workflow zu finden. Mit praxisnahem Monitoring, klaren Zuständigkeiten und einem getesteten Wiederherstellungsprozess können Sie proxyabhängige Abläufe zuverlässiger machen und souverän auf Unterbrechungen reagieren.
Häufig gestellte Fragen
Was bedeutet die Verfügbarkeit eines Proxy-Servers?
Die Verfügbarkeit eines Proxy-Servers ist der Anteil eines festgelegten Zeitraums, in dem der Proxy-Zugang Ihre betrieblichen Erfolgskriterien erfüllt. Ein antwortender Endpunkt zeigt die Verfügbarkeit auf einer Ebene, bestätigt aber nicht, dass Anfragen authentifiziert werden, ihr Ziel erreichen oder die vorgesehene Aufgabe abschließen. Für ein aussagekräftiges Maß legen Sie fest, welche Anfragen zählen, welche Antwortzeit akzeptabel ist und ob Erfolg den Abschluss eines Anwendungs-Workflows erfordert.
Wie kann ich die Verfügbarkeit eines Proxy-Servers überwachen?
Kombinieren Sie geplante synthetische Prüfungen mit Telemetrie aus echten Anwendungsanfragen. Erfassen Sie erfolgreiche berechtigte Anfragen im Verhältnis zu allen berechtigten Anfragen, Antwortzeitverteilungen, Timeouts, Fehlerkategorien und abgeschlossene Workflows. Nutzen Sie Prüfungen, die einer repräsentativen Route über den Proxy zu einem relevanten Ziel folgen, nicht nur einen Verbindungstest. Vergleichen Sie die Ergebnisse über mehrere Prüfstandorte, wenn die Geografie die Route beeinflusst, und protokollieren Sie Diagnosedaten, ohne Zugangsdaten oder unnötige Nutzerdaten zu speichern.
Kann Proxy-Rotation die Verfügbarkeit verbessern?
Rotation kann Anfragen auf mehrere IPs verteilen und eine andere Auswahl bieten, wenn eine bestimmte Route Probleme hat, verhindert Unterbrechungen aber nicht automatisch. Eine rotierte Anfrage kann trotzdem an Netzwerkproblemen, Proxy-Verfügbarkeit, Authentifizierung oder dem Verhalten des Ziels scheitern. Rotation kann außerdem Workflows stören, die von einer konsistenten Sitzungsidentität abhängen. Stimmen Sie den Ansatz auf die Aufgabe ab und überwachen Sie abgeschlossene Anfragen, um zu prüfen, ob die Rotation hilft.
Was passiert, wenn ein Proxy-Server ausfällt?
Anfragen über diese Route können fehlschlagen, in ein Timeout laufen oder abhängige Aufgaben unvollständig lassen, bis sich die Verbindung erholt oder die Anwendung eine geeignete Ausweichlösung nutzt. Die Auswirkungen hängen vom Workflow ab: Ein fortsetzbarer Datenerfassungsjob kann pausieren, während ein sitzungsabhängiger Prozess seine Kontinuität verlieren kann. Prüfen Sie Anwendungsprotokolle, Zugangsdaten, Netzwerkerreichbarkeit, Proxy-Antworten und Zielverhalten, um die fehlerhafte Ebene zu ermitteln, bevor Sie es erneut versuchen oder die Route wechseln.
Wie viel Proxy-Server-Verfügbarkeit braucht ein Unternehmen?
Legen Sie ein Verfügbarkeitsziel anhand der Folgen unterbrochener Arbeit, der verfügbaren Wiederherstellungszeit und der Leistungsanforderungen der Anwendung fest. Eine Aufgabe, die pausieren und fortgesetzt werden kann, verträgt möglicherweise ein anderes Maß an Störung als eine mit einem strikten Abschlussfenster. Definieren Sie zuerst Erfolgskriterien einschließlich akzeptabler Latenz und abgeschlossener Aufgaben und messen Sie dann reale Anwendungsergebnisse über einen einheitlichen Zeitraum. Es gibt kein Ziel, das zu jeder Arbeitslast passt.
Ist ein Residential- oder ein mobiler Proxy zuverlässiger für die Verfügbarkeit?
Keine der beiden Kategorien ist für jede Arbeitslast grundsätzlich zuverlässiger. Die Zuverlässigkeit hängt von der benötigten Konnektivität, dem Sitzungsverhalten, dem Standort, der Anwendung und dem Ziel ab sowie davon, wie das Setup überwacht und wiederhergestellt wird. Residential Proxys und dedizierte mobile Proxys, einschließlich 4G- und 5G-Optionen, decken unterschiedliche Konnektivitätsanforderungen ab. Testen Sie infrage kommende Infrastruktur über Ihren vorgesehenen Anwendungs-Workflow und vergleichen Sie dann abgeschlossene Aufgaben, Latenz und Fehlermuster.
Wie wirken sich Wiederholungen und Failover auf die Proxy-Verfügbarkeit aus?
Wiederholungen können vorübergehende Fehler beheben, während Failover Anfragen an einen alternativen Endpunkt leiten kann, wenn eine Route fehlerhaft ist. Unkontrollierte Wiederholungen können einen Ausfall verstärken oder doppelte Aktionen auslösen; legen Sie daher eine maximale Anzahl von Versuchen fest und nutzen Sie Backoff zwischen den Versuchen. Dokumentieren Sie, wann ein Failover erfolgen soll, und schützen Sie Sitzungs- und Datenintegrität. Testen Sie den gesamten Wiederherstellungspfad und bestätigen Sie den Erfolg anhand von Anwendungsanfragen statt nur anhand von Endpunktprüfungen.