


Rechtssicher mit Web-Scraping beginnen: Daten, Zugriff und Rechte

David
Öffentlich sichtbare Daten sind nicht automatisch uneingeschränkt nutzbar. Die Data Science Clinic der University of Chicago stellt fest, dass das Scraping öffentlicher Website-Daten an sich nicht illegal ist, doch damit ist nicht entschieden, ob ein bestimmtes Scraping rechtmäßig ist. Rechtssicher mit Web-Scraping zu beginnen bedeutet, zu bewerten, was Sie erfassen, wie Sie darauf zugreifen und was Sie damit vorhaben.
Schauen Sie über die Frage hinaus, ob eine Seite ohne Anmeldung lädt. Urheberrecht, personenbezogene Daten, Nutzungsbedingungen, Zugriffsbeschränkungen und die Auswirkungen automatisierter Anfragen können alle eine Rolle spielen, und die Regeln unterscheiden sich je nach Rechtsordnung. Dieser Leitfaden erklärt, wie diese Faktoren das rechtliche Risiko prägen, was Sie vor der Datenerfassung bedenken sollten und wie Sie Ihre Scraping-Pläne überprüfen. So erhalten Sie eine klarere Grundlage, um zu entscheiden, was Sie erfassen, wie Sie damit umgehen und wann Sie rechtlichen Rat einholen sollten.
Das Wichtigste in Kürze
- Prüfen Sie die Nutzungsbedingungen und Zugriffsregeln einer Website, bevor Sie Daten erfassen; öffentlicher Zugang allein räumt nicht jedes rechtliche Risiko aus.
- Trennen Sie faktische Informationen von geschützten kreativen Inhalten und berücksichtigen Sie, wie Ihr Verwendungszweck urheberrechtliche Fragen beeinflussen kann.
- Planen Sie das Verhalten Ihres Scrapers so, dass er Zugriffsgrenzen respektiert und die Website nicht unnötig belastet.
- Prüfen Sie, ob die erfassten Informationen Personen identifizieren, und klären Sie dann, welche Datenschutzregeln für Erfassung und Nutzung gelten können.
- Bauen Sie eine rechtliche Prüfung rund um Zielwebsite, Daten, Erfassungsmethode und Verwendungszweck auf, bevor Sie ein Scraping-Projekt skalieren.
Ist Web-Scraping legal oder illegal?
Web-Scraping ist nicht automatisch illegal, nur weil Daten online erscheinen. Die Data Science Clinic der University of Chicago stellt fest, dass das Scraping öffentlich verfügbarer Website-Daten an sich nicht illegal ist, Nutzungsbedingungen, Zugriffsmethoden und Verwendungszweck aber dennoch eine Rolle spielen.
Nutzungsbedingungen und Scraping
Nutzungsbedingungen legen Bedingungen für den Zugriff auf die Inhalte einer Website und deren Nutzung fest. Sie können automatisierte Erfassung, Kopieren oder Weiterverwendung einschränken, selbst wenn Seiten öffentlich sind. Die Data Science Clinic der University of Chicago rät, die geltenden Bedingungen des Datenanbieters einzuhalten. Lesen Sie sie, bevor Sie einen Collector entwickeln, und achten Sie auf Regeln zu Bots, Massenanfragen oder kommerzieller Nutzung.
Risiken einer Vertragsverletzung
Mit einer Klage wegen Vertragsverletzung wird geltend gemacht, dass eine Partei die Bedingungen einer Vereinbarung nicht erfüllt hat. Website-Betreiber haben Scraper und Käufer gescrapter Daten verklagt und argumentiert, dass die Bedingungen den Zugriff oder die spätere Nutzung einschränkten. Eine öffentliche Seite allein klärt nicht, ob ein Vertrag gilt oder verletzt wurde. Das hängt von der Vereinbarung ab, davon, wie sie präsentiert wurde, vom Verhalten des Nutzers und von der späteren Verwendung der Daten.
Clickwrap-Vereinbarungen und Nutzungsbedingungen
Clickwrap ist eine Online-Vereinbarung, bei der Nutzer Bedingungen akzeptieren, oft durch Anklicken einer Schaltfläche oder eines Kontrollkästchens. Die Zustimmung kann diese Bedingungen für spätere Aktivitäten über das Konto relevant machen. Wer zum Beispiel vor dem Zugriff auf ein Datenportal Bedingungen akzeptiert, schafft einen anderen vertraglichen Kontext als beim Aufrufen einer offenen Seite. Berücksichtigen Sie Kontozustimmung und Zugriff, wenn Sie einen Scraping-Plan bewerten.
Robots.txt und Nutzungsbedingungen von Websites
Eine robots.txt-Datei teilt die Präferenzen einer Website für automatisierte Crawler mit, unterscheidet sich aber von vertraglichen Bedingungen. Sie ersetzt keine Prüfung der Nutzungsbedingungen und klärt nicht jede rechtliche Frage. Dennoch rät die Data Science Clinic der University of Chicago, geltende Zugriffsrichtlinien zu befolgen, und Scraper in der EU sollten keine URLs scrapen, die in der robots.txt ausgeschlossen sind. Betrachten Sie einen ausgeschlossenen Pfad als klares Signal, anzuhalten und neu zu bewerten.
Nutzungsbedingungen und technische Zugriffsbeschränkungen können unterschiedliche Fragen aufwerfen. Eine Website kann Seitenaufrufe erlauben, während ihre Bedingungen die automatisierte Erfassung einschränken, oder die robots.txt kann Pfade benennen, die Crawler meiden sollen. In den USA entschied der Ninth Circuit, dass ein Website-Betreiber die Erlaubnis eines autorisierten Nutzers widerrufen kann, sodass ein späterer Zugriff durch den Scraper nach dem CFAA unbefugt sein kann. Prüfen Sie die Nutzungsbedingungen, Zugriffsbedingungen und etwaige Änderungen der Erlaubnis, bevor Sie fortfahren.
Wenn Sie rechtssicher mit Web-Scraping beginnen, unterscheiden Sie „öffentlich verfügbar“ von „uneingeschränkt“. Gerichte können die Vereinbarung und die Art des Zugriffs berücksichtigen, nicht nur, ob eine Seite im Browser geladen wurde. Sperrt eine Website ein Konto oder widerruft sie die Erlaubnis, kann ein Kontowechsel oder das Fortsetzen von Anfragen zusätzliche Probleme aufwerfen. Unterbrechen Sie die Erfassung, wenn Zugriffsbedingungen Ihrer geplanten Methode widersprechen, und bewerten Sie Quelle und Umfang dann neu.
Urheberrecht und Ausnahmen für Text- und Data-Mining
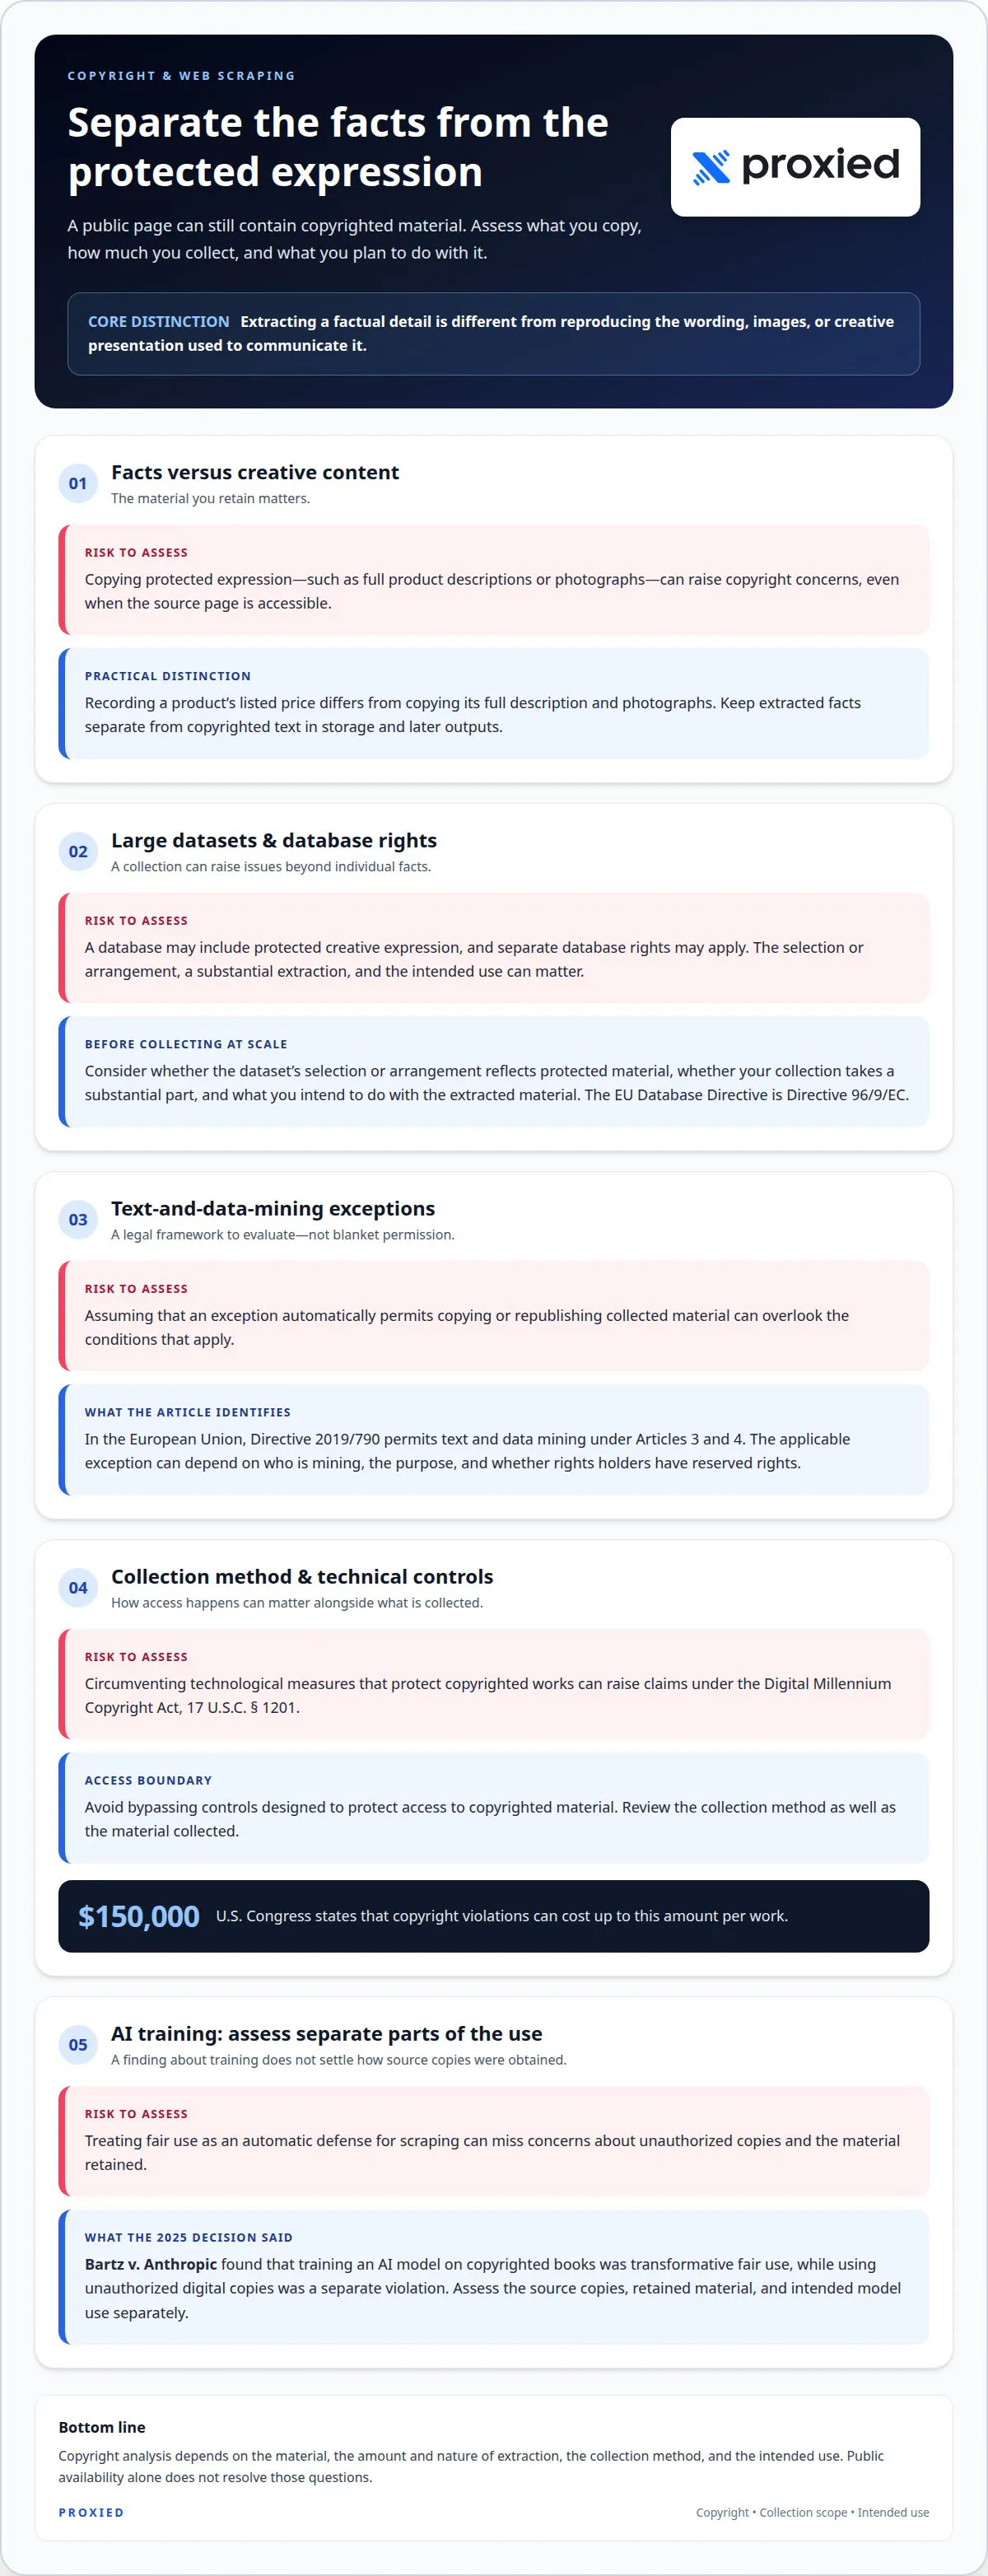
Scraping kann das Kopieren urheberrechtlich geschützten Materials umfassen, selbst wenn die Quellseite zugänglich ist. Eine zentrale Unterscheidung liegt oft zwischen dem Extrahieren von Fakten und dem Vervielfältigen geschützter Ausdrucksformen, zusammen mit Zweck und Umfang der Erfassung.
Ausnahmen für Text- und Data-Mining
Ausnahmen für Text- und Data-Mining erlauben unter bestimmten rechtlichen Voraussetzungen eine automatisierte Analyse von Inhalten. In der Europäischen Union erlaubt die Richtlinie 2019/790 Text- und Data-Mining nach den Artikeln 3 und 4. Welche Ausnahme gilt, kann davon abhängen, wer das Mining durchführt, zu welchem Zweck und ob Rechteinhaber sich ihre Rechte vorbehalten haben. Betrachten Sie die Ausnahme als rechtlichen Rahmen, den Sie prüfen müssen, nicht als pauschale Erlaubnis, erfasstes Material zu kopieren oder erneut zu veröffentlichen.
Urheberrechtsverletzung und DMCA-Schutzmechanismen
Eine Urheberrechtsverletzung kann entstehen, wenn beim Scraping geschützte Ausdrucksformen ohne gültige Rechtsgrundlage kopiert werden. Laut US-Kongress können Urheberrechtsverletzungen bis zu 150.000 US-Dollar pro Werk kosten. Der Digital Millennium Copyright Act, 17 U.S.C. § 1201, regelt Ansprüche wegen der Umgehung technischer Maßnahmen, die urheberrechtlich geschützte Werke schützen. Umgehen Sie keine Kontrollen, die den Zugriff auf urheberrechtlich geschütztes Material schützen sollen; die Erfassungsmethode kann ebenso wichtig sein wie das erfasste Material.
Urheberrechtlich geschützte Inhalte und Datenbankrechte
Eine Datenbank kann sowohl ungeschützte Fakten als auch geschützte kreative Ausdrucksformen enthalten, und es können zusätzlich eigene Datenbankrechte gelten. Die Datenbankrichtlinie der Europäischen Union, Richtlinie 96/9/EG, betrifft den rechtlichen Schutz von Datenbanken. Prüfen Sie vor der Erfassung eines großen Datensatzes, ob Auswahl oder Anordnung geschütztes Material widerspiegeln und ob die Erfassung einen wesentlichen Teil entnimmt. Art und Verwendungszweck der Entnahme können die rechtliche Bewertung beeinflussen.
Urheberrecht und faktische Informationen
Einzelne Fakten unterscheiden sich vom ursprünglichen Wortlaut, von Bildern oder von der kreativen Darstellung, mit der sie vermittelt werden. Den angegebenen Preis eines Produkts zu erfassen ist zum Beispiel etwas anderes, als seine vollständige Beschreibung und seine Fotos zu kopieren. Die Data Science Clinic der University of Chicago rät zu prüfen, ob Informationen faktisch sind und ob ihr Kopieren das Urheberrecht verletzen könnte. Halten Sie extrahierte Fakten in Speicherung und späteren Ausgaben getrennt von urheberrechtlich geschütztem Text.
KI-Training bringt eine weitere Ebene hinzu. Im Jahr 2025 entschied das Gericht im Verfahren Bartz v. Anthropic, dass das Training eines KI-Modells mit urheberrechtlich geschützten Büchern eine transformative Fair-Use-Nutzung war, während die Verwendung nicht autorisierter digitaler Kopien eine eigenständige Rechtsverletzung darstellte. Fair Use ist keine automatische Rechtfertigung für Scraping. Bewerten Sie die Quellkopien, das aufbewahrte Material und den vorgesehenen Einsatz des Modells getrennt; eine günstige Bewertung des Trainings beseitigt keine Bedenken darüber, wie das Quellmaterial beschafft wurde.
Rechtliche Prüfungen vor dem Scraping
Eine fundierte Prüfung betrachtet Quelle, Daten, Erfassungsmethode und Verwendungszweck gemeinsam. In den USA hängt die Rechtmäßigkeit von der Rechtsordnung und den konkreten Umständen ab, nicht einfach davon, ob eine Seite lädt.
Rechtliche Prüfung vor dem Scraping
Eine rechtliche Prüfung vor dem Scraping bewertet, ob eine geplante Erfassung geltende Gesetze und Zugriffsbedingungen einhält. Personenbezogene Daten, urheberrechtlich geschütztes Material und Erfassungsmethoden können jeweils das Risiko beeinflussen. Ermitteln Sie zunächst den Website-Betreiber, die Datenfelder und den Ort, auf den sich die Personen- oder Unternehmensdaten beziehen. Bewerten Sie anschließend den Verwendungszweck und ob es einen anderen rechtmäßigen Zugangsweg gibt, etwa eine API.
Berücksichtigen Sie bei US-Projekten den Computer Fraud and Abuse Act, das Urheberrecht und relevante Datenschutzgesetze der Bundesstaaten. California Penal Code § 502 ist ein bundesstaatliches Gegenstück zum CFAA. Eine Klage wegen Trespass to Chattels kann davon abhängen, ob der Zugriff unbefugt war und einen Schaden verursacht hat. Damit sind Methode und Auswirkung auf das System wichtig, nicht nur der Inhalt des Datensatzes.
Klassifizieren Sie als Nächstes jedes Feld. Die öffentliche Adresse eines Unternehmens wirft andere Fragen auf als die Profildaten oder biometrischen Informationen einer Person. Die Data Science Clinic der University of Chicago rät, nur Informationen zu scrapen, die ohne Passwortschranke öffentlich verfügbar sind. Ihre Empfehlungen umfassen auch, die API oder die spezifischen Datenzugriffsregeln einer Website zu respektieren, sofern vorhanden, und die Organisation zu fragen, ob sie die Daten direkt bereitstellen kann.
Rechtliche Schritte für einen einfachen Web-Scraper
Ein einfacher Scraper ruft Seiten ab und extrahiert ausgewählte Informationen; ein rechtlich durchdachtes Design begrenzt, worauf er zugreift und wie er sich verhält. Eine technisch erfolgreiche Erfassung kann dennoch rechtliche Risiken schaffen. Legen Sie zuerst Datensatz und Zweck fest und beschränken Sie die Anfragen dann auf erlaubte öffentliche Seiten und notwendige Felder.
- Wählen Sie die Quelle. Dokumentieren Sie die Website, die relevanten Bedingungen, die Zugriffshinweise und jede API oder jeden Kanal für Datenanfragen.
- Legen Sie den Umfang fest. Schließen Sie passwortgeschützte Seiten und Felder aus, die nichts mit dem erklärten Zweck der Erfassung zu tun haben.
- Steuern Sie die Anfragen. Die Data Science Clinic der University of Chicago rät, das Scraping so zu begrenzen, dass die Zielwebsite nicht überlastet wird. Nutzen Sie zurückhaltende Anfragemuster und stoppen Sie, wenn das System Anzeichen von Überlastung zeigt.
- Prüfen Sie die Ausgabe. Trennen Sie Fakten von kopiertem kreativem Material und bewerten Sie personenbezogene Informationen, bevor Sie Ergebnisse nutzen oder weitergeben.
Unternehmen sollten diese Entscheidungen dokumentieren, bevor die Erfassung beginnt. Eine kurze Aufzeichnung kann Quelle, freigegebene Felder, Zugriffsmethode, Verwendungszweck und die Bedingungen festhalten, die eine Pause auslösen. Überarbeiten Sie sie, wenn die Website ihre Zugriffsregeln ändert, der Datensatz wächst oder eine neue Nutzung hinzukommt. In den USA verknüpft dieser Prozess technische Entscheidungen mit den rechtlichen Faktoren, die für das konkrete Projekt gelten.
Welche Schritte sind nötig, um einen einfachen Web-Scraper rechtssicher aufzubauen?
Bauen Sie den Collector um einen festgelegten Zweck, einen erlaubten Zugriff und begrenzte Felder herum auf. Ein Produktkatalog-Projekt benötigt zum Beispiel möglicherweise Produktnamen und angegebene Spezifikationen, nicht jedes Seitenelement.
- Definieren Sie die Erfassung. Halten Sie Zweck des Projekts, Quelle und genau benötigte Felder schriftlich fest. Ein Datensatz zur Preisüberwachung benötigt vielleicht Produktnamen, angegebene Preise und Seitendaten. Schließen Sie nicht zugehörige Profile, Bilder oder Beschreibungen aus. Ein enger Umfang erleichtert die Bewertung, was der Scraper erfasst und wie die Ausgabe genutzt wird.
- Wählen Sie einen Zugangsweg. Nutzen Sie eine verfügbare API oder die angegebenen Datenzugriffsrichtlinien der Website, wenn sie zur Aufgabe passen. Die Data Science Clinic der University of Chicago rät, eine geltende API oder spezifische Zugriffsrichtlinien zu respektieren und die Organisation zu fragen, ob sie die Daten ohne Scraping bereitstellen kann. Meiden Sie passwortgeschützte Inhalte und Zugriffsmethoden, die Schranken umgehen.
- Implementieren Sie nur die erforderliche Extraktion. Konfigurieren Sie den Scraper so, dass er die ausgewählten Seiten anfordert und benannte Felder ausliest, statt standardmäßig ganze Seiten zu kopieren. Bei einem öffentlichen Katalog kann das bedeuten, Name und angezeigte Kategorie jedes Artikels zu extrahieren und Biografien oder Kundenkommentare zu ignorieren. Dokumentieren Sie Zielpfade und Ausgabefelder des Codes, damit spätere Änderungen die Erfassung nicht unbemerkt ausweiten.
- Begrenzen Sie die Auswirkung auf das System. Die Data Science Clinic der University of Chicago rät, das Scraping so zu begrenzen, dass die Zielwebsite nicht überlastet wird. Nutzen Sie ein zurückhaltendes Anfragemuster, vermeiden Sie unnötige Wiederholungsanfragen und stoppen Sie, wenn die Website Fehler oder Zugriffsbeschränkungen anzeigt. Ein Scraper, der jede fehlgeschlagene Seite erneut abruft, kann vermeidbare Last erzeugen, selbst wenn sein ursprünglicher Anfrageumfang klein war.
- Prüfen und kontrollieren Sie die Ausgabe. Vergleichen Sie Stichproben mit ihren Quellseiten, um Parsing-Fehler zu finden, und entfernen Sie dann Felder außerhalb des freigegebenen Umfangs. Halten Sie faktische Werte getrennt von kopiertem Text oder kreativem Material. Enthält die Ausgabe personenbezogene Informationen, bewerten Sie Verwendungszweck und Umgang damit, bevor Sie sie an ein anderes Team oder System weitergeben.
Führen Sie zusammen mit dem Code eine kurze Projektdokumentation. Halten Sie Quelle, Zweck, erfasste Felder, Zugangsweg und die Bedingungen fest, die eine Pause erfordern. Überarbeiten Sie sie, wenn die Erfassung wächst, die Quelle ihre Zugriffshinweise ändert oder die Daten eine neue Verwendung erhalten. Werden einem Katalogprojekt zum Beispiel Kundenbewertungen hinzugefügt, ist eine neue Bewertung nötig, weil sich das erfasste Material und mögliche rechtliche Folgen geändert haben.
Ein einfacher Scraper ist nicht schon deshalb rechtlich einwandfrei, weil er fehlerfrei läuft. Seine Grenzen müssen zum dokumentierten Zweck des Projekts passen, und seine Anfragen müssen in einem angemessenen Verhältnis zu diesem Umfang bleiben. Nutzen Sie das als praktischen Prüfpunkt vor dem Start und bei jeder Änderung des Designs.
Wie wirken sich Datenschutzgesetze der US-Bundesstaaten und internationale Datenschutzregeln auf Scraping aus den USA aus?
Ein in den USA ansässiger Scraper kann Informationen über Personen erfassen, die durch Gesetze außerhalb des Heimatstaats des Collectors geschützt sind. Berücksichtigen Sie, wessen Daten betroffen sind, wo sich diese Personen befinden und wie die Organisation die Daten erfasst und nutzt.
In den USA können der Computer Fraud and Abuse Act, das Urheberrecht und Datenschutzgesetze der Bundesstaaten relevant sein. Beispiele sind der California Consumer Privacy Act (CCPA), der Colorado Privacy Act (CPA) und der Virginia Consumer Data Protection Act (VCDPA). Diese Gesetze gelten nicht für jedes Unternehmen oder jeden Datensatz; ihre Anwendbarkeit kann vom Geltungsbereich des Gesetzes und den Tätigkeiten der Organisation abhängen.
Der CCPA gibt Einwohnern Kaliforniens das Recht zu erfahren, welche personenbezogenen Informationen erfasst und gespeichert werden, und deren Löschung zu verlangen. Er gilt für gewinnorientierte Unternehmen, die personenbezogene Daten von Einwohnern Kaliforniens erfassen und bestimmte Schwellenwerte erreichen. Ein Scraper, der Namen, Kontaktdaten oder Profilinformationen sammelt, sollte prüfen, ob seine Erfassung und spätere Nutzung in den Geltungsbereich des Gesetzes fallen.
Bei manchen Daten rücken spezifischere Regeln der Bundesstaaten in den Vordergrund. Der Biometric Information Privacy Act von Illinois, 740 ILCS 14/10, regelt die Erfassung, Nutzung, Aufbewahrung und Vernichtung biometrischer Identifizierungsdaten durch private Stellen. Er gilt für private Stellen, die in Illinois tätig sind oder dort Geschäfte betreiben, auch wenn sie ihren Hauptsitz anderswo haben. Ein US-Unternehmen, das Gesichtsbilder oder andere biometrische Merkmale scrapt, muss dieses Risiko getrennt von gewöhnlichen Kontaktdaten bewerten.
Auch internationale Regeln können in den USA ansässige Organisationen erfassen. Die 2018 eingeführte Datenschutz-Grundverordnung (DSGVO) kann für Organisationen außerhalb der Europäischen Union gelten, die in Europa Waren oder Dienstleistungen anbieten oder dort Verhalten beobachten. Sie definiert personenbezogene Daten als Informationen, die sich auf eine identifizierte oder identifizierbare natürliche Person beziehen. Ein öffentliches Profil kann dennoch eine Person identifizieren, daher beseitigt öffentliche Sichtbarkeit allein keine Datenschutzfragen.
Für personenbezogene Daten von EU-Bürgern erfordert DSGVO-konformes Scraping eine gültige Rechtsgrundlage, Informationen für die Betroffenen über die Erfassung, eine sichere Speicherung und Möglichkeiten, die Kontrolle über ihre Informationen auszuüben. Bilden Sie den Datenfluss von der Erfassung über Speicherung, Analyse und Weitergabe bis zur Löschung ab. Die Bußgelder der DSGVO können 20 Millionen Euro oder 4 % des weltweiten Umsatzes eines Unternehmens erreichen, weshalb eine Datenschutzbewertung vor Beginn der Erfassung wichtig ist.
Dokumentieren Sie für jedes Projekt die betroffenen Personen, Datenfelder, anwendbaren Rechtsordnungen, den Zweck und das Vorgehen bei der Aufbewahrung. Bewerten Sie neu, wenn der Scraper neue Felder hinzufügt oder der Datensatz eine andere Verwendung erhält. Proxy-Konnektivität kann den technischen Zugriff unterstützen, schafft aber weder eine Erlaubnis noch eine datenschutzrechtliche Grundlage. Prüfen Sie Konnektivitätsoptionen als eigenständigen Teil Ihres Erfassungs-Setups.
Proxied
Proxied bietet Konnektivitätsoptionen für die Web-Automatisierung, darunter dedizierte 4G-Mobile-Proxys, dedizierte 5G-Mobile-Proxys und Residential Proxys. Sie können zu Projekten passen, die Proxy-Konnektivität als Teil ihres technischen Setups benötigen. Wählen Sie die Option, die zu Ihrem Workflow und Ihren Erfassungsanforderungen passt.
Die Nutzung eines Proxys gewährt keine Erlaubnis für den Zugriff auf eine Website, setzt deren Nutzungsbedingungen nicht außer Kraft und macht die Erfassung personenbezogener oder urheberrechtlich geschützter Daten nicht rechtmäßig. Halten Sie Ihre rechtliche Prüfung, Ihre Zugriffsentscheidungen und den Umgang mit Daten getrennt von der Konnektivitätsebene. Wenn Proxy-Konnektivität für Ihr Scraping-Setup relevant ist, kontaktieren Sie Proxied, um Ihre Anforderungen zu besprechen.
Bauen Sie eine verantwortungsvolle Scraping-Praxis auf
Für Teams, die rechtssicher mit Web-Scraping beginnen, ist die erste Erfassung der Beginn eines fortlaufenden Prozesses, keine einmalige Freigabe. Benennen Sie eine verantwortliche Person für Umfang und Prüfung des Projekts, wann immer sich Datensatz, Zweck oder technisches Setup ändern. So bleiben Entscheidungen auf die tatsächliche Nutzung der Daten abgestimmt.
Gestalten Sie den Workflow praxisnah: Dokumentieren Sie, warum Sie jedes Feld erfassen, beschränken Sie den Zugriff auf Personen, die die Daten benötigen, und legen Sie einen klaren Zeitpunkt für die Neubewertung ihrer Nutzung fest. Ein Wechsel von interner Analyse zur Veröffentlichung oder Weitergabe von Daten erfordert zum Beispiel eine neue Prüfung. Halten Sie Entscheidungen zur technischen Konnektivität getrennt von rechtlicher Erlaubnis und Datenschutzpflichten.
Proxied bietet dedizierte 4G-Mobile-Proxys und dedizierte 5G-Mobile-Proxys als Konnektivitätsoptionen für die Web-Automatisierung sowie kostenlose virtuelle Rufnummern für den Empfang von SMS-Nachrichten. Diese Tools können das technische Setup unterstützen, während die Entscheidungen zu Zugriff und Datennutzung im Mittelpunkt einer verantwortungsvollen Erfassung bleiben.
Besprechen Sie Ihren Scraping-Bedarf mit Proxied und planen Sie ein Setup, das zu Ihrem Workflow passt. Gehen Sie den nächsten Schritt mit einem klaren Umfang und einem verantwortungsvollen Ansatz.
Häufig gestellte Fragen
Sind Web-Scraping-Dienste ein legitimes Geschäft?
Web-Scraping kann eine legitime Geschäftsdienstleistung sein, doch das macht nicht jedes Scraping-Projekt rechtmäßig. Ein Anbieter kann Daten für Marktanalysen erfassen, während der Verwendungszweck eines Kunden eigene Fragen aufwirft. Interne Preisvergleiche unterscheiden sich zum Beispiel von der erneuten Veröffentlichung von Daten zusammen mit kopierten Produktbeschreibungen. Bewerten Sie für jedes Projekt Zielwebsite, Daten, Erfassungsmethode und geplante Nutzung.
Wie sieht es mit Web-Scraping weltweit aus?
Die Regeln unterscheiden sich je nach Rechtsordnung, daher muss ein US-Unternehmen möglicherweise Gesetze außerhalb der USA berücksichtigen. Die DSGVO kann für Organisationen außerhalb der EU gelten, die dort Waren oder Dienstleistungen anbieten oder Verhalten beobachten. Weitere Beispiele sind der Data Protection Act des Vereinigten Königreichs, das brasilianische LGPD und das kanadische PIPEDA. Ermitteln Sie, wo sich die mit dem Datensatz verbundenen Personen und Organisationen befinden, bevor Sie Erfassungs- und Aufbewahrungspraktiken festlegen.
Welche Gesetze gelten für Web-Scraping?
Web-Scraping kann Fragen nach Gesetzen zu Computerzugriff, Verträgen, Urheberrecht, Datenbanken und Datenschutz aufwerfen. Welche Regeln relevant sind, hängt von Website, erfassten Informationen, Zugriffsmethode und Verwendungszweck ab. Bei einem Projekt mit EU-Datenbanken kann zum Beispiel die EU-Datenbankrichtlinie neben Datenschutzregeln relevant sein. Behandeln Sie diese als getrennte rechtliche Fragen: Die Klärung einer Frage löst die anderen nicht automatisch.
Welche Gesetze gelten in den USA für Web-Scraping?
In den USA zählen zu den relevanten Gesetzen der Computer Fraud and Abuse Act, das Urheberrecht und Datenschutzgesetze der Bundesstaaten. Beispiele auf Ebene der Bundesstaaten sind der CCPA, der Colorado Privacy Act und der Virginia Consumer Data Protection Act. California Penal Code § 502 ist ein bundesstaatliches Gegenstück zum CFAA. Auch der Biometric Information Privacy Act von Illinois kann relevant sein, wenn ein Projekt biometrische Merkmale erfasst, etwa Gesichtsbilder zur Identifizierung von Personen.
Sind Nutzungsbedingungen von Websites gegenüber Web-Scrapern rechtlich durchsetzbar?
Nutzungsbedingungen können eine vertragliche Klage stützen, doch die Durchsetzbarkeit hängt von der Vereinbarung und den Umständen ab. Ein sichtbarer Zustimmungsschritt, etwa die Auswahl von „Ich stimme zu“ vor dem Zugriff auf ein Datenportal, kann zeigen, dass ein Nutzer die Bedingungen akzeptiert hat. Die Klage eines Website-Betreibers kann sich auch darauf beziehen, wie der Scraper auf Daten zugegriffen oder die Ergebnisse genutzt hat. Prüfen Sie die Bedingungen auf Einschränkungen bei Automatisierung, Kopieren und Weiterverwendung.
Wie kann ich die robots.txt und die Scraping-Richtlinie einer Website prüfen?
Öffnen Sie die robots.txt-Datei der Website und suchen Sie nach Regeln, die für Ihren Crawler oder die Pfade gelten, die Ihr Programm anfordern soll. Eine „Disallow“-Regel signalisiert, dass der aufgeführte Pfad vom angegebenen User-Agent nicht gecrawlt werden soll. Prüfen Sie dann die Nutzungsbedingungen der Website und jede separate Datenzugriffsrichtlinie. Gibt es eine API oder einen Zugriffsleitfaden, vergleichen Sie die dort erlaubten Felder und Methoden mit Ihrer geplanten Erfassung.
Ist das Scraping personenbezogener Daten nach US-Datenschutzgesetzen wie dem CCPA legal?
Die Erfassung personenbezogener Informationen kann je nach Daten, Unternehmen und anwendbarem Recht Datenschutzanforderungen unterliegen. Ein Unternehmen, das Profildaten von Einwohnern Kaliforniens erfasst, sollte zum Beispiel prüfen, ob der CCPA gilt und wie es mit Anfragen zu erfassten Informationen umgeht. Der Geltungsbereich des Gesetzes hängt von bestimmten Schwellenwerten für Unternehmen ab. Prüfen Sie außerdem, ob die Datensätze sensible Kennungen oder Informationen enthalten, die unter ein anderes Gesetz eines Bundesstaats fallen.
Welche Risiken durch Urheberrecht und Datenbankrechte bestehen in den USA bei gescrapten Inhalten?
Das Kopieren geschützter Ausdrucksformen, etwa der Produktbeschreibungen eines Autors oder originaler Fotos, kann urheberrechtliche Bedenken aufwerfen; das Extrahieren einer bloßen Tatsache ist etwas anderes. Prüfen Sie, was der Scraper speichert und was das Endprodukt anzeigt. Fragen zu Datenbanken hängen ebenfalls vom Umfang und von der Nutzung der Erfassung ab. Bei einem Datensatz mit Bezug zu einer EU-Datenbank kann die EU-Datenbankrichtlinie eine zusätzliche Überlegung darstellen, selbst wenn der Scraper aus den USA betrieben wird.