


Hochleistungs-Proxys für Data Mining: Proxy-Typen im Vergleich

David
Der schnellste Proxy ist nicht immer die beste Wahl für Data Mining. Hochleistungs-Proxys für Data Mining hängen von der Zielwebsite ab: Rechenzentrum-Proxys eignen sich für Aufgaben mit hohem Volumen auf Websites mit wenigen Schutzmechanismen, Residential Proxys können helfen, wenn Websites Hosting-Bereiche blockieren, und Mobile Proxys sind eine Option für restriktivere Endpunkte.
Es liegt nahe, sich auf Geschwindigkeit zu konzentrieren, doch der Durchsatz allein entscheidet nicht darüber, ob ein Datenerfassungs-Workflow zuverlässig läuft. Der Proxy-Typ beeinflusst auch, wie Anfragen für eine Zielwebsite erscheinen, während Rotation, Sitzungssteuerung, Wiederholungsversuche und eine verantwortungsvolle Taktung der Anfragen bestimmen, wie gut eine Pipeline arbeitet. Dieser Vergleich erklärt, was Proxys leisten, wie sich Residential, Mobile und Rechenzentrum-Optionen unterscheiden und welche anderen Proxy-Setups zu bestimmten Anforderungen passen können. Außerdem behandelt er praktische Steuerungsmöglichkeiten für Anfragen im großen Umfang, damit Sie anhand von Ziel, Arbeitslast und erwarteten Hürden entscheiden können.
Das Wichtigste in Kürze
- Stimmen Sie den Proxy-Typ auf die Zielwebsite ab: Rechenzentrum-Proxys eignen sich für Ziele mit hohem Volumen und wenig Schutz, während Residential und Mobile Optionen zu unterschiedlich starken Blockierungen und Fingerprinting passen.
- Wählen Sie Rotation oder eine Sticky Session danach, ob Ihr Workflow wechselnde IPs oder eine konsistente Verbindung über zusammengehörige Anfragen hinweg benötigt.
- Stimmen Sie die Proxy-Protokolle auf Ihre Scraping-Tools und den Traffic ab, den diese verarbeiten müssen.
- Verfolgen Sie Erfolgsquoten, Wiederholungsversuche und Kosten pro Datensatz, um Probleme zu erkennen, bevor sie die gesamte Datenpipeline verlangsamen.
- Nutzen Sie kontrollierte Anfragetaktung, Caching und intelligente Wiederholungsversuche, um Erfassungs-Workflows widerstandsfähiger zu machen.
Wie wichtig sind Rotation und Sitzungssteuerung in Data-Science-Workflows?
Es gibt keine verifizierte Rangliste der Anbieter nach Geschwindigkeit und Verfügbarkeit. Rechenzentrum-Proxys eignen sich in der Regel für geschwindigkeitsorientierte Arbeit, während Residential Proxys zu Zielen passen können, die Hosting-Bereiche blockieren. Stimmen Sie bei der Aggregation von Flugpreisen Proxy-Typ und Sitzungsverhalten auf jede Airline oder Buchungsseite ab und messen Sie die Ergebnisse dann an Ihren Erfassungsanforderungen.
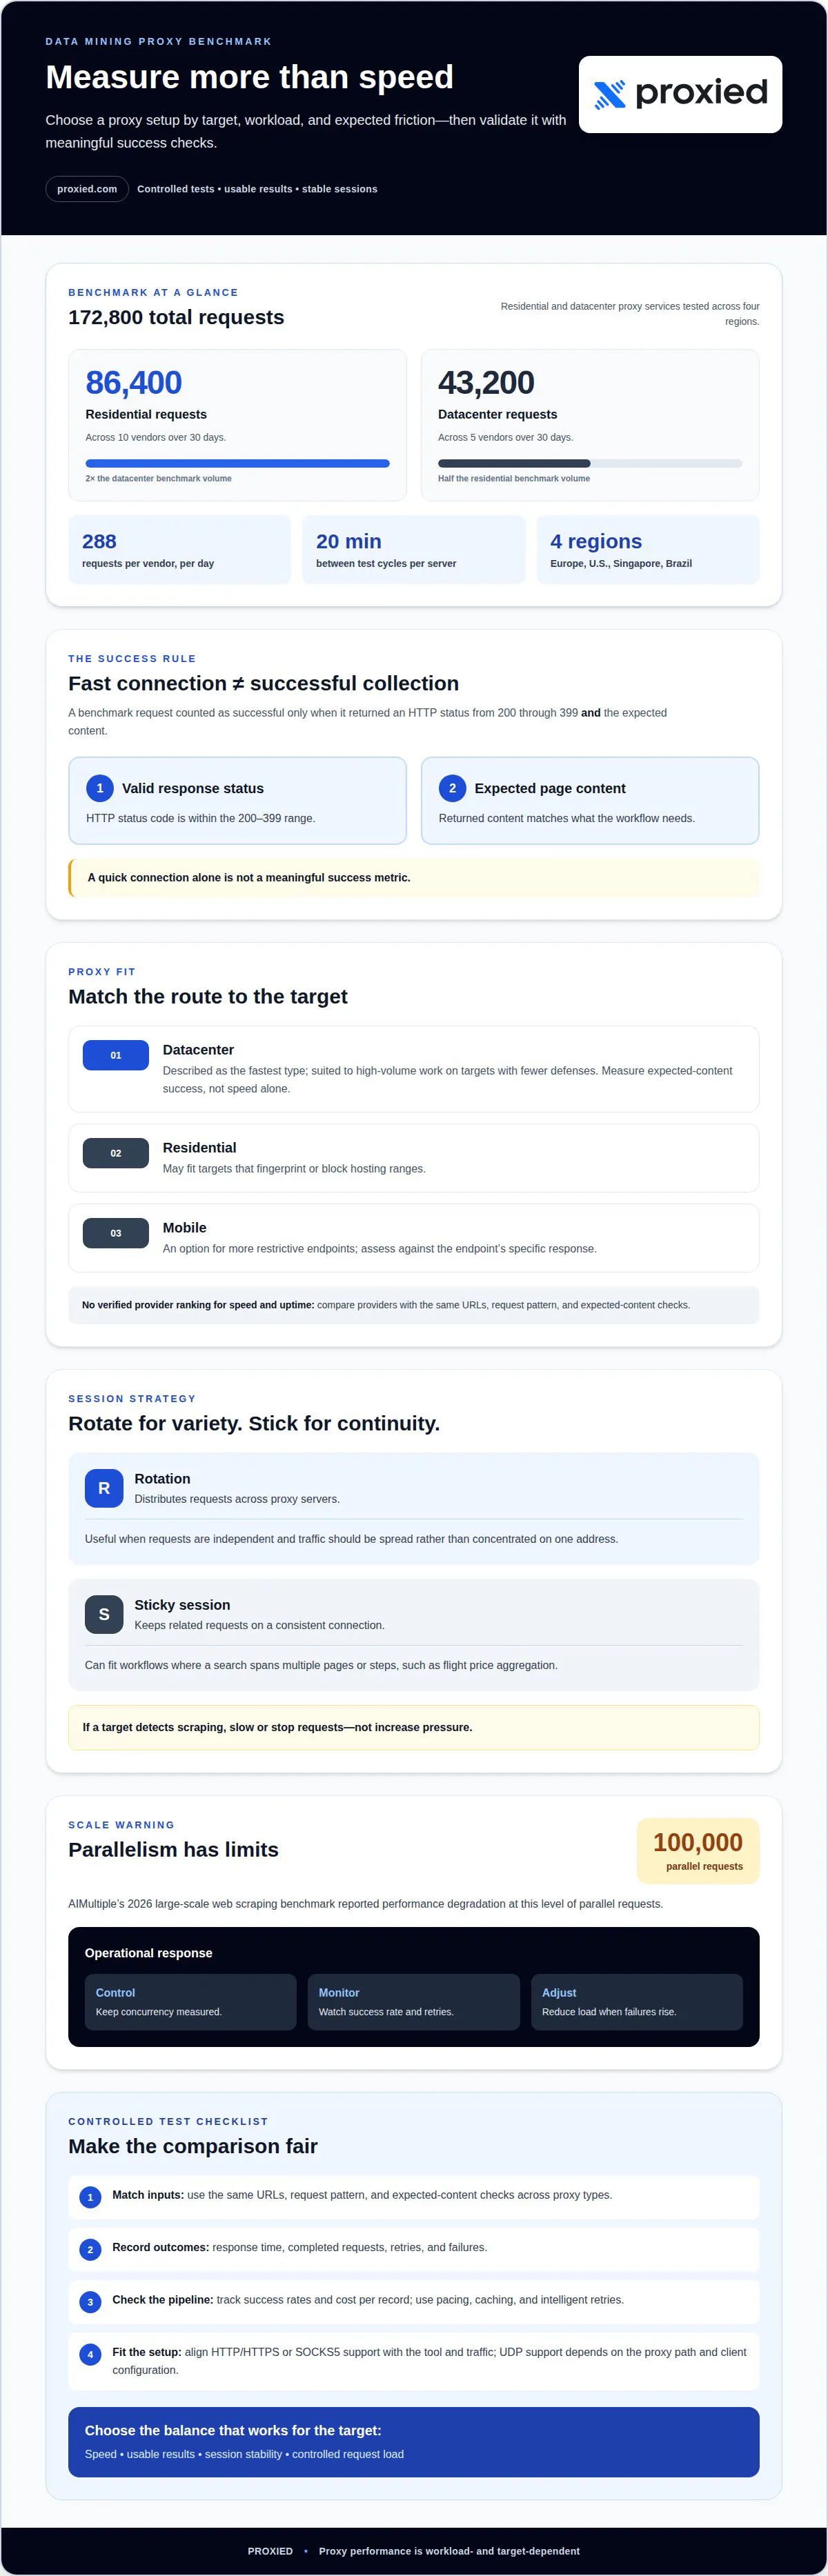
Benchmark-Zahlen helfen, den Vergleich einzuordnen, sagen aber nicht jeden Scraping-Auftrag voraus. Ein Benchmark für Residential Proxys erzeugte 86.400 Anfragen bei 10 Anbietern über 30 Tage. Ein Benchmark für Rechenzentrum-Proxys erzeugte 43.200 Anfragen bei 5 Anbietern über 30 Tage. Jeder Anbieter erhielt 288 Anfragen pro Tag, mit einem Testzyklus alle 20 Minuten von jedem Testserver. Insgesamt erzeugte der Benchmark 172.800 Anfragen bei Diensten, die in Europa, den Vereinigten Staaten, Singapur und Brasilien getestet wurden.
Testen Sie Geschwindigkeit und Zuverlässigkeit mit einem kontrollierten Workflow, bevor Sie einen Anbieter auswählen. Führen Sie dieselben URLs, dasselbe Anfragemuster und dieselben Inhaltsprüfungen über jeden Proxy-Typ aus. Erfassen Sie Antwortzeit, abgeschlossene Anfragen, Wiederholungsversuche und Fehler. Eine Benchmark-Anfrage gilt als erfolgreich, wenn sie einen HTTP-Statuscode zwischen 200 und 399 sowie den erwarteten Inhalt liefert. Diese Definition macht eine erfolgreiche Antwort aussagekräftiger als eine bloß schnelle Verbindung.
Rotation verteilt Anfragen auf Proxy-Server, während Sticky Sessions zusammengehörige Anfragen auf einer gleichbleibenden Verbindung halten. Die Aggregation von Flugpreisen kann eine stabile Sitzung erfordern, wenn sich eine Suche über mehrere Seiten oder Schritte erstreckt. Sind Anfragen unabhängig voneinander, kann Rotation den Traffic verteilen und die Konzentration auf eine Adresse verringern. Setzen Sie Grenzen mit Bedacht; erkennt Google oder ein anderes Ziel das Scraping, verlangsamen oder stoppen Sie die Anfragen, statt den Druck zu erhöhen.
Infrastruktur gewinnt mit steigendem Anfragevolumen an Bedeutung: Load Balancing verteilt die Arbeit auf verfügbare Proxy-Server, während Monitoring hilft, überlastete Routen zu erkennen. Der Large-Scale-Web-Scraping-Benchmark 2026 von AIMultiple meldete Leistungseinbußen bei 100.000 parallelen Anfragen. Dieses Ergebnis ist eine nützliche Warnung davor, anzunehmen, dass sich Parallelität unbegrenzt skalieren lässt. Halten Sie die Parallelität kontrolliert, überwachen Sie Erfolgsquote und Wiederholungsversuche und passen Sie die Last an, wenn die Fehler zunehmen.
Testen Sie dieselbe Arbeitslast auf Ihrem Ziel mit verschiedenen Proxy-Typen und wählen Sie dann die Option, die Geschwindigkeit, nutzbare Ergebnisse und Sitzungsstabilität ausbalanciert.
Rechenzentrum-Proxys können eine schnelle Option sein, doch kein einzelner Anbieter wird als der mit der höchsten Geschwindigkeit und Verfügbarkeit ausgewiesen. Vergleichen Sie Anbieter mit kontrollierten Tests, die Antwortzeiten, abgeschlossene Anfragen, Wiederholungsversuche und Fehler erfassen.
Warum sind Proxys für Data Science wichtig?
Ein Proxy leitet eine Anfrage über eine andere IP-Adresse statt über die direkte Verbindung des Nutzers. Kostenlose öffentliche Proxys können unsicher sein oder ohne Vorwarnung verschwinden, und ein niedriger Preis allein sagt nichts über Verfügbarkeit oder Leistung aus.
Unterstützte Proxy-Protokolle
HTTP- und HTTPS-Proxys verarbeiten Web-Anfragen und passen daher häufig zu browserbasiertem Scraping. SOCKS5 arbeitet auf einer niedrigeren Netzwerkebene und kann je nach Anwendung verschiedene Arten von Traffic übertragen. UDP-Unterstützung ist für Traffic über UDP wichtig, einschließlich QUIC, hängt aber vom Proxy-Pfad und der Client-Konfiguration ab. Stimmen Sie das Protokoll auf die Software ab, bevor Sie einen Erfassungsauftrag starten.
Die Protokollunterstützung beeinflusst auch Einrichtung und Fehlerbehebung. Ein Crawler, der für HTTPS-Anfragen konfiguriert ist, kann keine Proxy-Verbindung nutzen, die er nicht unterstützt. Prüfen Sie die Dokumentation auf unterstützte Protokolle, Authentifizierungsschritte, Verbindungsbeispiele und Hinweise zu Fehlern und testen Sie dann eine kleine Anfrage gegen das vorgesehene Ziel. So lässt sich eine Protokollinkompatibilität von einer Antwort des Ziels oder einem Netzwerkproblem unterscheiden.
Proxys im Data Mining
Beim Web-Scraping sieht eine Zielwebsite die IP-Adresse des Proxys statt der ursprünglichen IP des Nutzers. Das kann helfen, Anfragen auf mehrere Adressen zu verteilen und öffentliche Informationen von verschiedenen Standorten aus zu erfassen. Rotation ändert die verwendete Adresse über Anfragen hinweg, während Sitzungssteuerung die Kontinuität erhalten kann, wenn zusammengehörige Anfragen durchgehend verbunden bleiben müssen.
Proxys ersetzen keine sorgfältige Erfassungslogik. Eine Datenpipeline braucht weiterhin eine sinnvolle Taktung der Anfragen, Wiederholungsversuche und Prüfungen, ob zurückgegebene Seiten die erwarteten Informationen enthalten. Liefert eine Produktseite zum Beispiel einen Fehler oder unvollständige Ergebnisse, sollte der Scraper dieses Ergebnis erfassen, statt es als gültige Daten zu behandeln. Modelle, die mit gescrapten Datensätzen trainiert werden, hängen von der Qualität dieser Eingaben ab.
Nützlicher technischer Support und eine gute Dokumentation erklären, wie Sie eine Verbindung konfigurieren, Fehler interpretieren und feststellen, ob ein Fehler von der Authentifizierung, der Proxy-Route oder dem Ziel ausgeht. Ein verwaltetes Setup kann den Betrieb von Proxy-Infrastruktur erleichtern, doch Sie müssen die Ergebnisse der Anfragen weiterhin überwachen. Protokollieren Sie Fehler und Wiederholungsversuche, um wiederkehrende Verbindungsprobleme zu erkennen.
Nutzen Sie eine gezielte Bewertung, bevor Sie einen Data-Mining-Workflow ausweiten:
- Bestätigen Sie, dass das Protokoll mit dem Scraping-Tool und dem Ziel funktioniert.
- Führen Sie repräsentative Anfragen aus und prüfen Sie die zurückgegebenen Inhalte.
- Verfolgen Sie Fehler, Wiederholungsversuche und Verbindungsstabilität im gesamten Workflow.
- Prüfen Sie die Dokumentation auf Schritte zur Einrichtung und Fehlerbehebung.
Diese Prüfungen helfen, Probleme der Proxy-Konnektivität von Anwendungsproblemen zu unterscheiden. Sie zeigen auch, ob das Setup zu einer einzelnen Datenquelle oder zu einer verwalteten Pipeline mit mehreren Zielen passt. Als praktischen nächsten Schritt sollten Sie Proxy-Optionen für die Datenerfassung prüfen und mit den Protokoll- und Sitzungsanforderungen Ihres Workflows vergleichen.
Rotation, Sticky Sessions und Steuerung von Wiederholungsversuchen
Rotation, Sitzungspersistenz, Abkühlphasen und dosierte Wiederholungsversuche bestimmen, wie Scraping-Traffic durch ein Proxy-Netzwerk läuft. Diese Steuerungen können wiederkehrende Anfragemuster verringern, doch CAPTCHA-Antworten hängen auch vom Verhalten der Zielwebsite ab.
Rotierende und Sticky Sessions
Eine rotierende Sitzung wechselt die Proxy-IP zwischen Anfragen oder in einem konfigurierten Intervall. Das kann die Datenerfassung auf mehrere Server verteilen, während eine Sticky Session eine IP für zusammengehörige Aktionen beibehält. Eine Produktsuche mit anschließender Paginierung benötigt zum Beispiel möglicherweise dieselbe Sitzung, um den Zustand der Website zu erhalten. Ein Crawler, der unabhängige Seiten erfasst, kann dagegen zwischen Anfragen rotieren. Entscheiden Sie nach dem Workflow, nicht nach einer pauschalen Regel.
Eine Kombination beider Ansätze kann zu einem Auftrag mit unterschiedlichen Phasen passen. Ein Scraper könnte während einer mehrseitigen Aufgabe eine Sticky Session beibehalten und dann rotieren, bevor er eine neue beginnt. Liefert eine Sitzung einen Fehler, erfassen Sie die Antwort, bevor Sie die Adresse wechseln. Andernfalls kann ein IP-Wechsel ein wiederkehrendes Problem mit dem Ziel, der Anfragelogik oder dem Netzwerk verschleiern.
Pool-Tiefe und IP-Rotation
Die Pool-Tiefe beschreibt die Bandbreite der Proxy-IPs, die für die Rotation verfügbar sind. Ein tieferer Pool bietet einem Auftrag mit hohem Volumen mehr Adressen, auf die er Anfragen verteilen kann, während ein schmaler Pool Adressen schnell wiederverwenden kann. Rechenzentrum-Proxys können zu durchsatzorientierten Workflows passen, doch auch die Rotation muss die Ratenbegrenzungen und Antwortmuster des Ziels respektieren.
Erfassen Sie, welche IP jede Anfrage bearbeitet hat und ob sie erfolgreich war. Erhalten mehrere Adressen ähnliche Fehler, liegt die Ursache möglicherweise im Anfragemuster und nicht bei einem einzelnen Server. Häufen sich Fehler bei einer Adresse, nehmen Sie sie vorübergehend aus der aktiven Rotation. Dieses Protokoll hilft, Pool-Probleme von Fehlern im Scraper zu unterscheiden, ohne das Anfragevolumen blind zu erhöhen.
IP-Rotation und Abkühlphasen
Eine Abkühlphase pausiert eine IP nach einem festgelegten Ereignis, etwa einer Antwort wegen Ratenbegrenzung oder wiederholten Verbindungsfehlern. Anders als Rotation allein verhindert die Abkühllogik, dass dieselbe Adresse sofort in die Warteschlange zurückkehrt. Ein Scheduler kann eine IP zum Beispiel als nicht verfügbar markieren, nachdem ein Ziel übermäßigen Traffic signalisiert hat, und sie nach der Pause wieder freigeben.
Legen Sie Abkühlphasen anhand beobachteter Antworten fest, nicht anhand willkürlicher Annahmen. Ein vorübergehender Netzwerkfehler kann einen kurzen erneuten Versuch rechtfertigen, während ein Sperrsignal verlangt, diese Route zu pausieren und die Anfragen zu reduzieren. Protokollieren Sie Ereignis, IP und Ergebnis des erneuten Versuchs. Diese Aufzeichnung hilft, die Rotation zu verfeinern und wiederholte Anfragen an eine Quelle zu vermeiden, die sie bereits ablehnt.
Sperren und CAPTCHAs vermeiden
Zu den Funktionen, die wiederholte Signale begrenzen helfen, gehören Rotation über mehrere Server, Sticky Sessions für mehrstufige Aktivitäten und Abkühlphasen nach Ratenbegrenzungen. Kombinieren Sie sie mit einer sorgfältigen Taktung der Anfragen. Die Verteilung von Scraping-Anfragen auf Proxy-Server kann beim Umgang mit Ratenbegrenzungen helfen, doch ein aggressives Volumen kann die Schutzmechanismen eines Ziels trotzdem auslösen.
Nutzen Sie eine kontrollierte Richtlinie für Wiederholungsversuche. Wiederholen Sie vorübergehende Verbindungsfehler nach einer Pause, senden Sie Anfragen nach einem CAPTCHA oder einer eindeutigen Sperrantwort aber nicht wiederholt erneut. Reduzieren Sie die Anfragerate oder stoppen Sie die Erfassung, wenn das Ziel das Scraping erkennt. So verhindern Sie, dass Wiederholungsversuche dasselbe Muster verstärken, und geben dem Workflow für jeden Fehler eine klare Reaktion.
Wie halte ich die Erfolgsquote im großen Umfang hoch?
Halten Sie die Erfolgsquote hoch, indem Sie Sitzungsstabilität, gültige Inhalte, Wiederholungsversuche und Durchsatz gemeinsam überwachen. Data Mining mit Verbraucherdaten, das personenbezogene Profile verarbeitet, muss laut Europäischer Kommission und der California Privacy Protection Agency Vorschriften wie DSGVO und CCPA einhalten.
Sitzungsstabilität und Erfolgsquoten
Zusammengehörige Anfragen in einer Sitzung zu halten, kann helfen, die Kontinuität einer mehrstufigen Aufgabe zu wahren. Ein Crawler benötigt zum Beispiel möglicherweise eine Sitzung, um eine Suchseite zu laden, einem Ergebnis zu folgen und dessen Details abzurufen. Häufige Wechsel mitten in der Aufgabe können diesen Ablauf unterbrechen oder inkonsistente Datensätze erzeugen.
Messen Sie die Sitzungsqualität zusammen mit der Gültigkeit der Daten. Eine erfolgreiche Verbindung kann dennoch eine Sperrseite, eine unvollständige Liste oder veraltete Inhalte liefern. Erfassen Sie für jeden Batch Ziel, Sitzungskennung, Antwort und erwartete Felder. Häufen sich Fehler innerhalb einer Sitzung, pausieren Sie diese Route und versuchen Sie es nur dann über eine neue Sitzung erneut, wenn es angemessen ist.
Erfolgsquoten und Durchsatz
Der Durchsatz misst, wie schnell ein Workflow Anfragen verarbeitet; der Erfolg misst, wie viele davon nutzbare Datensätze liefern. Ein höheres Anfragevolumen kann den nutzbaren Ertrag verringern, wenn Wiederholungsversuche, Sperren oder fehlerhafte Seiten zunehmen. Eine Unternehmens-Pipeline sollte abgeschlossene Datensätze zusammen mit der Gesamtzahl der Anfragen erfassen, statt reine Anfragezahlen als Fortschritt zu werten.
Führen Sie einen gestuften Lasttest durch, bevor Sie die Erfassung ausweiten. Beginnen Sie mit einer repräsentativen Auswahl von Seiten, bestätigen Sie die extrahierten Felder und erhöhen Sie dann die parallele Arbeit schrittweise. Erfassen Sie in jeder Stufe Erfolg, Häufigkeit der Wiederholungsversuche und Verzögerungen in der Warteschlange. Steigen die Fehler mit wachsendem Durchsatz, reduzieren Sie die Parallelität und ermitteln Sie, ob die Ursache in der Sitzungsverwaltung, den Antworten des Ziels oder der Netzwerkkapazität liegt.
Dokumentieren Sie jede Quelle und jeden Erfassungslauf. Notieren Sie, welche Seitenmuster funktioniert haben, welche Felder erwartet werden und wie der Scraper mit Fehlern umgeht. So können Teams einen vorübergehenden Fehler von einem wiederkehrenden Datenqualitätsproblem unterscheiden, ohne Anfragen blind zu wiederholen.
Verantwortungsvolle Anfrageraten
Verantwortungsvolle Anfrageraten schützen Zielwebsites und helfen, vermeidbare Sperren zu verhindern. Verteilen Sie Anfragen mit Bedacht, respektieren Sie Ratenbegrenzungen und vermeiden Sie Traffic, der eine Website beschädigen oder stören könnte. Erkennt ein Ziel das Scraping, verlangsamen oder stoppen Sie die Erfassung, statt das Volumen zu erhöhen oder aggressiv erneut zu versuchen.
Nutzen Sie Backoff, wenn Fehler auftreten: Pausieren Sie Anfragen nach wiederholten Fehlern und setzen Sie sie mit niedrigerer Rate fort, wenn sich die Antworten erholen. Speichern Sie Ergebnisse im Cache, damit die Pipeline unveränderte Seiten nicht wiederholt abruft. Legen Sie Grenzen für Wiederholungsversuche fest und stellen Sie sicher, dass eine fehlerhafte Quelle keine unabhängigen Aufträge blockiert. Diese Steuerungen begrenzen Fehler, statt sie zu vervielfachen.
Bewerten Sie die Leistung pro Quelle, nicht nur für das gesamte Netzwerk. Eine insgesamt gute Erfolgsquote kann verbergen, dass ein einzelnes Ziel unbrauchbare Daten liefert. Vergleichen Sie gültige Datensätze, Wiederholungsversuche und Verzögerungen in der Warteschlange für jede Quelle und passen Sie deren Anfragetakt unabhängig an. So bleiben Unternehmens-Arbeitslasten reaktionsfähig und berücksichtigen das Verhalten jeder Website.
Residential, Mobile und Rechenzentrum-Proxys
Die Wahl des Proxys bestimmt, wie eine Data-Science-Pipeline jedes Ziel erreicht und wie ihre Anfragen behandelt werden. Residential, Mobile und Rechenzentrum-Proxys nutzen unterschiedliche IP-Quellen, daher hängt die beste Wahl von den Schutzmechanismen des Ziels, der Arbeitslast und den Erkennungsmustern ab. Hochleistungs-Proxys für Data Mining auszuwählen bedeutet, den Verbindungstyp auf eine konkrete Aufgabe abzustimmen, statt ein Setup auf jede Quelle anzuwenden.
Residential-Proxy-IP-Adressen sind echten Computern zugeordnet. Dieser Typ kann zu Zielen passen, die Traffic per Fingerprinting erkennen, Anfragen begrenzen oder Hosting-Bereiche blockieren. Erhält ein Scraper für Produktlisten zum Beispiel wiederholt Sperren für Hosting-Bereiche, können Residential-IPs für diese Quelle besser geeignet sein. Bewerten Sie die Ergebnisse, indem Sie prüfen, ob die erwarteten Felder ankommen, nicht nur, ob die Verbindung zustande kommt.
Rechenzentrum-IP-Adressen stammen von Servern statt von physischen Geräten. Rechenzentrum-Proxys können sich für die Erfassung großer Volumen bei Zielen mit wenigen Schutzmechanismen eignen, bei denen Geschwindigkeit Priorität hat. Blockiert eine Quelle Hosting-Bereiche, kann das weitere Senden von Anfragen über diese Route zu mehr Fehlern statt zu nützlichen Datensätzen führen. Ziehen Sie diese Option für Quellen in Betracht, die konsistent auf hostingbasierten Traffic antworten.
Mobile Proxys nutzen IP-Adressen, die Mobilfunknetzen zugeordnet sind. Sie können zu schwierigeren Endpunkten passen, insbesondere wenn Residential- oder Rechenzentrum-Routen auf stärkere Erkennung stoßen. ISP-Proxys können als Mittelweg für große Aufträge dienen, die das Vertrauen von Residential-IPs mit höherem Durchsatz verbinden müssen. Diese Kategorien unterscheiden sich in IP-Herkunft und Zieleignung, vergleichen Sie sie daher mit dem Verhalten jeder Quelle.
- Residential: Für Ziele in Betracht ziehen, die Traffic per Fingerprinting erkennen oder Hosting-Bereiche blockieren.
- Rechenzentrum: Für die Erfassung großer Volumen nutzen, wenn Ziele wenig Schutz bieten.
- ISP: Für große Aufträge in Betracht ziehen, die Residential-Vertrauen und Durchsatz ausbalancieren.
- Mobile: Für Endpunkte vorsehen, bei denen andere Proxy-Typen auf stärkere Erkennung stoßen.
Eine gemischte Pipeline kann Proxy-Typen nach Quelle zuweisen. Nutzen Sie zum Beispiel Rechenzentrum-Proxys für offene Katalogseiten, Residential Proxys für Quellen, die Hosting-Bereiche blockieren, und Mobile Proxys für schwierige Endpunkte. Prüfen Sie Fehler und gültige Datensätze für jedes Ziel. Beginnt eine Website, Sperren zurückzugeben, reduzieren Sie den Anfragetakt oder pausieren Sie die Erfassung, statt dieselben Anfragen zu wiederholen.
Ein praktischer Weg, Hochleistungs-Proxys für Data Mining auszuwählen, besteht darin, jede Route auf eine beobachtete Einschränkung des Ziels abzustimmen und dann zu prüfen, ob die erfassten Daten nützlich bleiben. Entdecken Sie Proxy-Optionen für die Datenerfassung, die zum Zielmix Ihrer Pipeline passen.
Proxied: Rechenzentrum-Proxys
Proxied bietet Rechenzentrum-Proxys für Datenerfassungs-Workflows, die den Durchsatz bei Zielen mit wenig Schutz priorisieren. Sie sind eine passende Option, wenn Ihre Pipeline Anfragen effizient verarbeiten muss und das Ziel keine Hosting-Bereiche blockiert. Blockiert eine Quelle Rechenzentrum-IPs, können Residential oder Mobile Proxys besser geeignet sein; Proxied bietet außerdem dedizierte 4G-Mobile-Proxys und dedizierte 5G-Mobile-Proxys für Workflows, die einen Mobile-Proxy-Typ erfordern.
Entscheiden Sie nach den Hürden, auf die Ihre Erfassungsaufgabe stößt. Rechenzentrum-Proxys können zu geschwindigkeitsorientierter Arbeit passen, während Mobile Proxys für schwierigere Endpunkte geeignet sein können. Stimmen Sie den Proxy-Typ auf Ihre Ziele ab, überwachen Sie die Qualität der Antworten und passen Sie den Workflow an, wenn Sperren auftreten.
Kontaktieren Sie Proxied, um zu besprechen, welche Proxy-Option zu Ihrem Datenerfassungs-Workflow passt.
Entwickeln Sie eine anpassungsfähige Proxy-Strategie
Betrachten Sie die Proxy-Auswahl als betriebliche Entscheidung, nicht als einmalige Einstellung. Wenn sich Quellenabdeckung, Seitenverhalten und Erfassungsziele ändern, überprüfen Sie den Routing-Plan und passen Sie an, wie jeder Workflow seine Proxy-Verbindung nutzt. Die Prüfung neuer Ziele kann zeigen, ob das aktuelle Setup noch passt, bevor eine Routenänderung eine größere Pipeline beeinflusst. Treffen Sie Entscheidungen auf Grundlage der Anforderungen der Quellen und der Qualität der erfassten Daten.
Proxied bietet dedizierte 4G-Mobile-Proxys und dedizierte 5G-Mobile-Proxys für Workflows, die Mobile-Proxy-Optionen benötigen, sowie kostenlose virtuelle Rufnummern für den Empfang von SMS-Nachrichten. Hochleistungs-Proxys für Data Mining auszuwählen bedeutet, die Konnektivität auf die Aufgabe abzustimmen und das Setup dann weiterzuentwickeln, wenn sich Ihr Datenbedarf ändert.
Kontaktieren Sie Proxied zu Proxy-Optionen, um einen passenden nächsten Schritt für Ihren Workflow zu besprechen. Ein klarer, anpassungsfähiger Ansatz kann Ihnen helfen, mit Sicherheit voranzukommen.
Häufig gestellte Fragen
Was sind Proxys?
Ein Proxy ist ein Vermittler, der Traffic zwischen Ihrer Anwendung und einer Zielwebsite weiterleitet. Er gibt einem Datenerfassungs-Workflow eine separate Netzwerkroute und kann helfen, Anfragen nach Quelle, Sitzung oder Aufgabe zu organisieren. Ein Team kann zum Beispiel Anfragen für Produktseiten über eine Proxy-Gruppe und Anfragen für Suchseiten über eine andere leiten und dann die Protokolle vergleichen, um herauszufinden, wo Verbindungs- oder Inhaltsprobleme beginnen.
Wie unterscheiden sich Hochgeschwindigkeits-Proxys von regulären Proxys?
Hochgeschwindigkeit beschreibt meist ein Proxy-Setup, das ausgewählt oder konfiguriert wurde, um Verzögerungen zu verringern und eine Arbeitslast effizient zu bewältigen; es garantiert keine bestimmte Antwortzeit. Die tatsächliche Leistung hängt auch vom Ziel, der Netzwerkroute, der Anfragegröße und der Scraping-Anwendung ab. Für einen aussagekräftigen Vergleich führen Sie dieselben Seiten und dieselbe Extraktionslogik über jedes Setup aus und bewerten die Antwortzeit zusammen mit nutzbaren Ergebnissen und Fehlern.
Welche Geschwindigkeiten kann ich erwarten?
Es gibt keine einheitliche erwartbare Geschwindigkeit für jede Data-Mining-Aufgabe. Eine schlanke Textseite und eine Seite mit umfangreichen Skripten oder Medien stellen unterschiedliche Anforderungen an die Verbindung. Auch die Antwortzeit des Ziels und die Route zwischen Proxy und Website beeinflussen die Abschlusszeit. Testen Sie repräsentative URLs mit Ihrem tatsächlichen Client und erfassen Sie sowohl die verstrichene Zeit als auch, ob die erwarteten Felder korrekt angekommen sind.
Welche Proxy-Typen eignen sich am besten für Hochleistungs-Data-Mining: Rechenzentrum, Residential oder ISP?
Rechenzentrum-Proxys können sich für die Erfassung großer Volumen eignen, wenn ein Ziel wenige Schutzmechanismen hat; Residential Proxys können zu Zielen passen, die Hosting-Bereiche blockieren. ISP-Proxys können als Mittelweg für große Aufträge dienen, die Residential-Vertrauen mit höherem Durchsatz suchen. Entscheiden Sie nach Quelle, nicht für ein ganzes Projekt: Eine Pipeline kann Rechenzentrum-Zugänge für offene Katalogseiten und Residential-Zugänge für eine restriktivere Quelle nutzen.
Wie viele gleichzeitige Verbindungen und Anfragen pro Sekunde können Data-Mining-Proxys bewältigen?
Es gibt keine einheitliche Kapazitätsangabe für jeden Proxy, jedes Ziel und jede Arbeitslast. Die Angebote für dedizierte Mobile Proxys bei Proxied zeigen für jedes Gerät eine Download- und Upload-Geschwindigkeit an; die meisten bieten unbegrenztes Datenvolumen, einige haben ein tägliches Fair-Usage-Limit. Auch die Zielwebsite und die Verarbeitung der Anfragen beeinflussen den nutzbaren Durchsatz. Erhöhen Sie die Parallelität schrittweise in einem kontrollierten Test und achten Sie auf zunehmende Fehler, langsamere Antworten oder unvollständige Datensätze, bevor Sie einen Live-Auftrag ausweiten.
Wie unterscheiden sich rotierende Proxys und Sticky Sessions beim Data Mining?
Rotierende Proxys wechseln die verwendete IP über Anfragen hinweg, während Sticky Sessions eine IP für eine konfigurierte Dauer beibehalten. Nutzen Sie eine Sticky Session, wenn der Workflow einer Anwendung auf Kontinuität angewiesen ist, etwa beim Durchblättern von Suchergebnissen vor dem Öffnen einer Detailseite. Rotation kann zu unabhängigen Anfragen passen. Gruppieren Sie die Arbeit nach Aufgaben und wählen Sie dann das Sitzungsverhalten, das den erforderlichen Zustand ohne unnötige Wiederholungsanfragen erhält.
Wie sollte ich Proxy-Pools, Rotation, Wiederholungsversuche und Ratenbegrenzungen für Data Mining konfigurieren?
Gruppieren Sie Anfragen zunächst nach Ziel und Aufgabe und weisen Sie jeder Gruppe einen passenden Pool und ein passendes Sitzungsverhalten zu. Legen Sie für jede Quelle einen respektvollen Anfragetakt fest, protokollieren Sie Antworten und wiederholen Sie nur Fehler, die vorübergehend erscheinen. Behandeln Sie Sperren oder CAPTCHA-Seiten als Signale, die Erfassung zu pausieren oder zu reduzieren, nicht als Grund für intensivere Wiederholungsversuche. Speichern Sie unveränderte Ergebnisse im Cache und prüfen Sie gültige Datensätze zusammen mit den Verbindungsergebnissen.
Welche Proxy-Anbieter bieten die höchsten Geschwindigkeiten und die beste Verfügbarkeit für Data Mining?
Rechenzentrum-Proxys werden als schnellster Typ beschrieben, doch kein einzelner Anbieter wird als der mit der höchsten Geschwindigkeit und Verfügbarkeit ausgewiesen. Vergleichen Sie Anbieter mit derselben Arbeitslast und erfassen Sie Antwortzeiten, abgeschlossene Anfragen, Wiederholungsversuche und Fehler.